Anthropic تطلق Fable 5.2 وMythos 5.2 بإنجازات في البرمجة والعلوم
أعلنت شركة Anthropic في 9 نوفمبر 2026 إطلاق نموذجي Claude Fable 5.2 وClaude Mythos 5.2، مع تحسينات جوهرية في البرمجة والاستدلال وفهم الصور وسرعة الاستجابة. وركزت الشركة على قدرات الإصدار الجديد في إدارة المشروعات الهندسية طويلة الأمد عبر تنسيق آلاف وكلاء الذكاء الاصطناعي، إلى جانب نتائج بحثية شملت مسائل في الفيزياء النظرية، وتوثيق براهين رياضية، وتصميم أجهزة إلكترونية عاملة.
وجاء الإصدار الجديد بعد Fable 5.1 وMythos 5.1 اللذين ظهرا في سبتمبر الماضي. واعتمدت Anthropic مسارين مختلفين للوصول إلى النموذجين؛ إذ أصبح Fable 5.2 متاحًا للمستخدمين والمطورين، بينما اقتصر Mythos 5.2 على المؤسسات التي تجتاز إجراءات الاعتماد الأمني لدى الشركة، نظرًا إلى قدراته المتقدمة في اكتشاف الثغرات والتعامل مع المهام الحساسة.
Claude Fable 5.2 وMythos 5.2.. أبرز التحسينات الجديدة
ركزت Anthropic على أربعة مجالات رئيسية في هذا الإصدار: هندسة البرمجيات، والاستدلال، ومعالجة الصور، وسرعة توليد المخرجات. ويبرز التطور الأهم في التعامل مع المهام الممتدة (Long-horizon Agentic Tasks)، وهي مشروعات تحتاج إلى مئات الخطوات المترابطة، وقد تستمر لساعات أو أيام قبل اكتمالها.
وتعتمد هذه الطريقة على تقسيم المشروع إلى مهام أصغر، ثم توزيعها على مجموعة من وكلاء الذكاء الاصطناعي، مع متابعة تنفيذ الأجزاء المختلفة وربط نتائجها. ويمنح هذا الأسلوب Fable 5.2 دورًا يتجاوز كتابة الشيفرات أو إصلاح الأخطاء؛ إذ أصبح التركيز على إدارة مراحل المشروع وتنسيق العمل بين الوكلاء.
وأظهرت مقاييس الحماية انخفاضًا حادًا في معدلات الرفض الخاطئ (False Refusals) بنسبة تقارب 55% مقارنة بـFable 5.1، مما يتيح مرونة أوسع في اختبارات الأمن السيبراني والأبحاث البيولوجية، مع الإبقاء على ضوابط الحماية الصارمة للمهام الحساسة.
بناء نظام تشغيل باستخدام أكثر من 1000 وكيل ذكاء اصطناعي
من أبرز التجارب التي كشفت عنها Anthropic مشروع بناء نظام تشغيل انطلاقًا من مجلد فارغ، بمشاركة أكثر من 1000 وكيل ذكاء اصطناعي عملوا بالتوازي على مدار ثمانية أيام.
وشملت نتيجة المشروع نواة التشغيل (Kernel)، وبرامج تعريف الأجهزة، ونظام تخزين دائم، وواجهة للنوافذ، وشاشة لتسجيل الدخول، إلى جانب برنامج تثبيت. ووصل العمل إلى مرحلة تشغيل النظام على حاسوب محمول فعلي.
وتبرز أهمية التجربة في حجم التنسيق المطلوب بين الوكلاء؛ فبناء نظام تشغيل لا يقتصر على كتابة الشيفرات، بل يحتاج إلى توافق مكونات متعددة، من إدارة الذاكرة والتخزين إلى التعامل مع الأجهزة وواجهة الاستخدام.
وفي تجربة هندسية أخرى، استعان الفريق بإصدار مبكر من Fable 5.2 لنقل خدمة إنتاجية معقدة مكتوبة بلغة Python إلى Rust. وأظهرت قياسات الأداء الفعلية قفزة في سرعة تشغيل الخدمة بنحو 26 ضعفًا بعد عملية النقل، مما يثبت الجدوى العملية لعمليات التحديث الآلي للأنظمة القائمة، وهي مهمة تستنزف عادةً وقتًا وجهدًا كبيرين من فرق التطوير.
نتائج Claude Fable 5.2 وMythos 5.2 في اختبارات الأداء المعيارية
عرضت Anthropic بالتعاون مع جهات تقييم مستقلة حزمة شاملة من نتائج الاختبارات المعيارية (Benchmarks) لقياس قدرات النموذجين عبر مجالات البرمجة، والبحث العلمي، والأمن السيبراني، والتحكم بالأنظمة والروبوتات:
| الاختبار / المؤشر | المجال والتخصص | النتيجة | دلالة النتيجة والمقارنة |
|---|---|---|---|
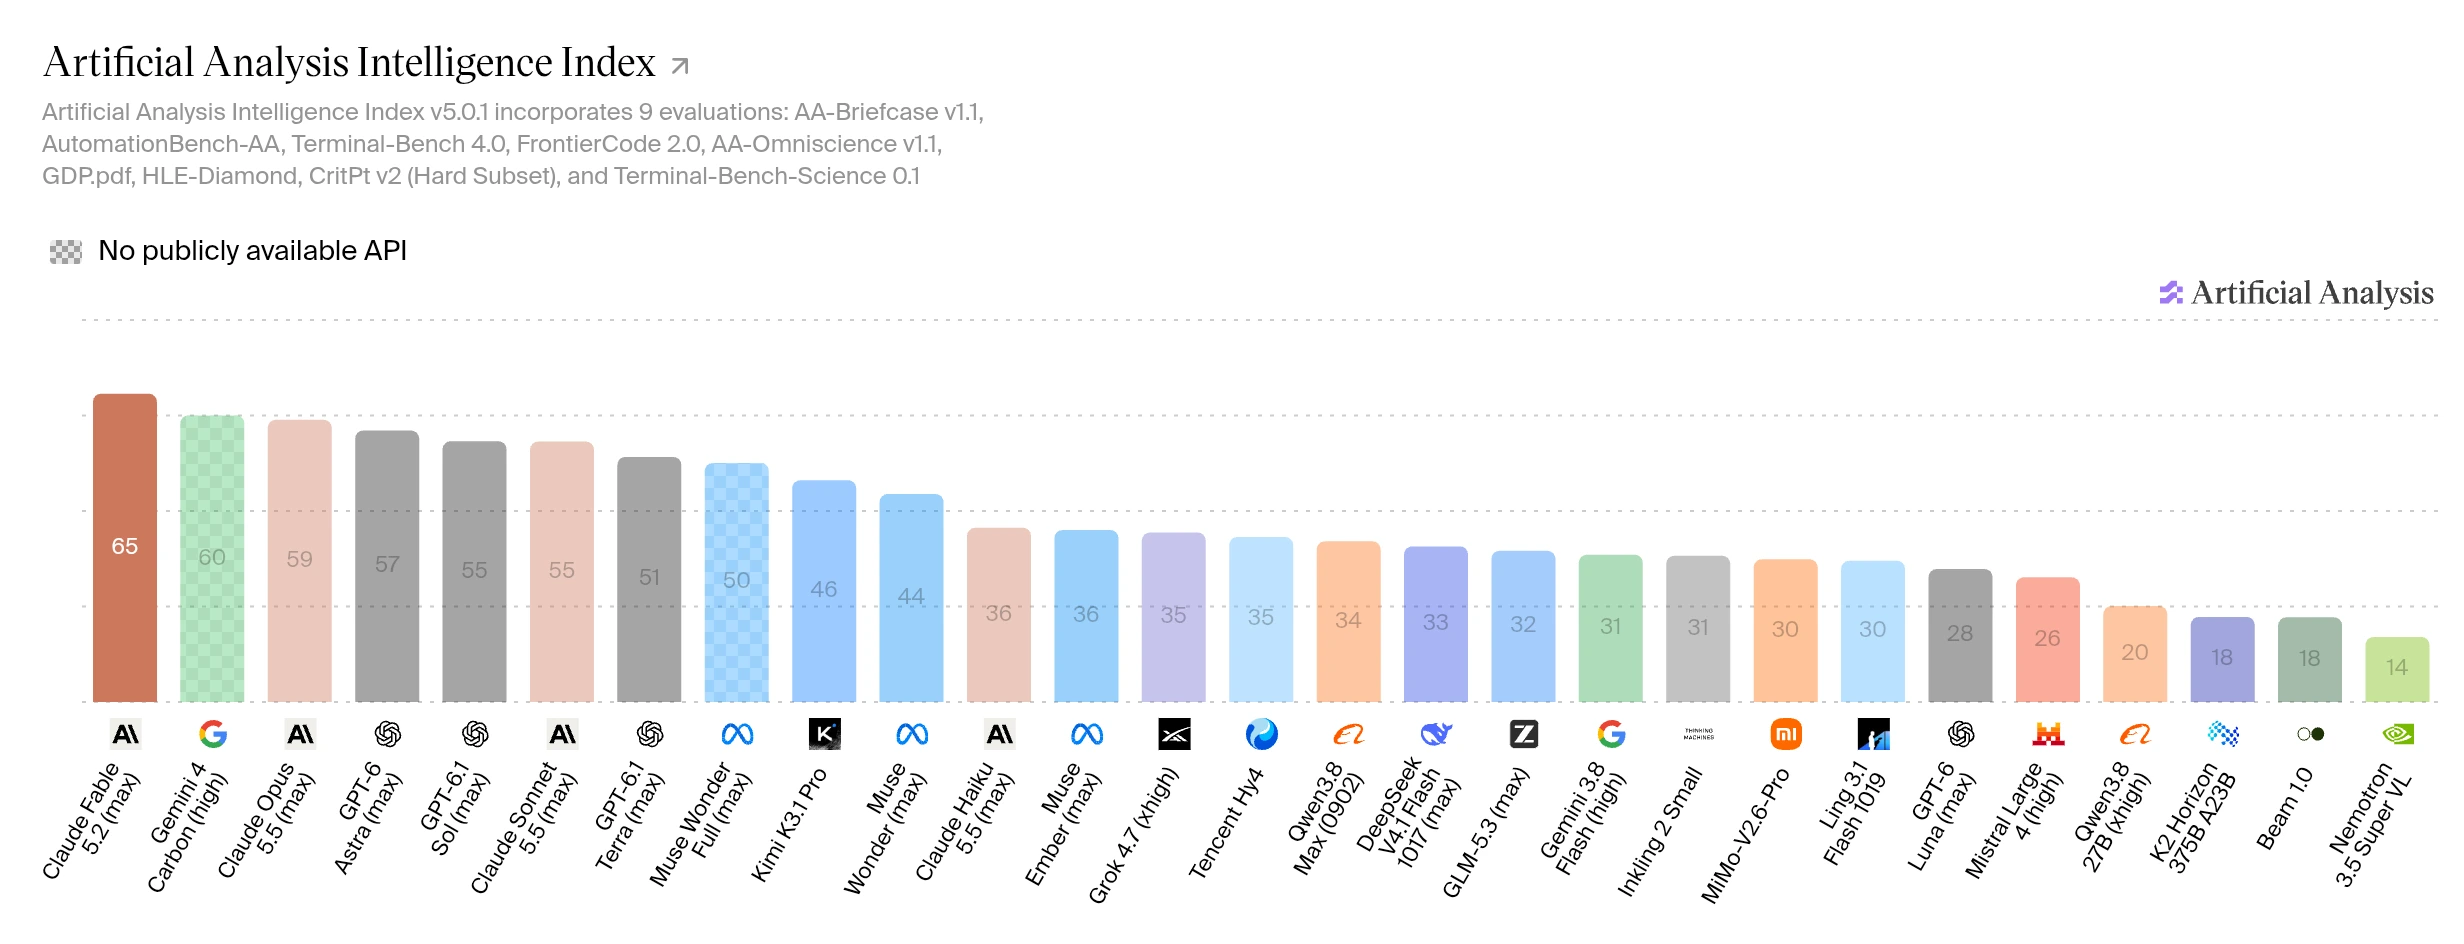
| Artificial Analysis (Intelligence Index) | مؤشر الذكاء العام المستقل | 65 نقطة | المركز الأول عالمياً (مقابل 60 لـ Gemini و57 لـ GPT-6 Astra) |
| FrontierCode 2.0 (Xhigh) | البرمجة المعقدة عبر الوكلاء | 49.1% | أعلى نتيجة مسجلة في الاختبار عالمياً |
| FrontierSWE v2 | هندسة برمجيات واقعية وإصلاح أخطاء | 69.9% | قفزة نوعية مقارنة بـ 56.3% للإصدار السابق |
| Terminal-Bench-Science 0.1 | أبحاث واستدلال علمي عبر الطرفية | 75.3% لـMythos (و74.6% لـFable) | تفوق كاسح لـ Mythos مقابل GPT-6 Astra (64.6%) |
| CyScenarioBench | سيناريوهات الدفاع السيبراني المتقدم | 76.3% لـMythos | أداء استثنائي في كشف واحتواء الهجمات |
| CVE Rediscovery | اكتشاف الثغرات الأمنية المعروفة | 89.6% لـMythos | إعادة اكتشاف شبه كاملة للثغرات الحقيقية الموثقة |
| OSWorld 2.1 | التحكم المباشر في بيئات الحاسوب | 89.3% | دقة فائقة في إدارة أنظمة التشغيل والبرمجيات |
| Humanity’s Last Exam (مع الأدوات) | الاستدلال الأكاديمي متعدد التخصصات | 74.2% | حل مسائل بالغة التعقيد في العلوم الدقيقة |
| RoboDojo Sim | محاكاة التحكم الحركي بالروبوتات | 64.9% | مضاعفة الأداء مقارنة بالجيل السابق (27.6%) |
| AutomationBench | أتمتة المهام المكتبية الروتينية | 51.4% | تقارب تنافسي مع Gemini 4 Carbon (53.9%) |
وفي اختبار FrontierCode 2.0، سجل Fable 5.2 نسبة 49.1% عند استخدام مستوى الاستدلال Xhigh، متفوقاً على كافة النماذج المنافسة في الساحة بما فيها Claude Opus 5.5 (45.5%) وGPT-6 Astra (42.8%). أما في معيار FrontierSWE v2 المخصص لاختبار قدرة النماذج على حل مشكلات برمجية حقيقية في مستودعات الأكواد، فقد قفزت النتيجة إلى 69.9%، ما يعكس نضج النموذج في التطبيق العملي للشركات.
كما أثبت النموذج كفاءة لافتة في اختبار Humanity’s Last Exam بنسبة 74.2% بمساعدة الأدوات البرمجية، وهو الاختبار المصمم لقياس أقصى حدود الاستدلال البشري في فروع العلوم والرياضيات المتقدمة.
ورغم هذه الصدارة العامة، تكشف النتائج عن تقارب تنافسي في قطاعات الأتمتة الإدارية الروتينية؛ إذ سجل
Gemini 4 Carbon نسبة 53.9% في AutomationBench مقابل 51.4% لـFable 5.2، ما يوضح تركيز Anthropic الأساسي على المهام الهندسية والبرمجية المعقدة بدل العمليات المكتبية البسيطة.
تقييم Artificial Analysis ومؤشر الذكاء العام (Intelligence Index)
حقق Fable 5.2 إنجازاً بارزاً بتصدره مؤشر الذكاء العام (Intelligence Index) الصادر عن منصة Artificial Analysis المستقلة بنتيجة 65 نقطة (عند مستوى الجهد الأقصى)، محتلاً المركز الأول عالمياً ومتقدماً على Gemini 4 Carbon (60 نقطة)، وClaude Opus 5.5 (59 نقطة)، وGPT-6 Astra (57 نقطة)، في حين يقف متوسط أداء نماذج السوق عند 31 نقطة.
كما شمل التقييم اختبار AA-Briefcase v1.1 المستقل، الذي يقيس قدرة وكلاء الذكاء الاصطناعي على تنفيذ مشاريع مهنية متكاملة؛ حيث حقق Fable 5.2 نسبة 66.1% وفق معايير التصحيح الدقيقة و1785 نقطة بمقياس Elo عبر 91 مهمة معقدة شملت بناء نماذج مالية، وإعداد العروض التقديمية، والتحليلات المؤسسية المعمقة.
أين يقع Fable 5.2 في Vals Index؟
يقيس مؤشر Vals Index قدرة نماذج الذكاء الاصطناعي على إنجاز أعمال اقتصادية واقعية في قطاعات التمويل والبرمجة والقانون بأوزان تعكس حجمها في الاقتصاد الفعلي.
وبينما يستعد المؤشر لتحديث لوحته الاقتصادية لتشمل الجيل الجديد، تظهر البيانات السابقة هيمنة نماذج Anthropic على المراكز الأولى بقيادة Opus 5.5 (69.69%) وSonnet 5.5 (69.22%) وFable 5.1 (68.83%). ومع القفزة البرمجية والكفاءة العالية التي أظهرها Fable 5.2، تشير المعطيات إلى قدرته على تصدر التقييم الاقتصادي فور إدراج بياناته رسمياً.
Mythos 5.2 وقدرات اكتشاف الثغرات الأمنية
يمثل الأمن السيبراني أحد أبرز المجالات التي ركزت عليها Anthropic في تطوير Mythos 5.2. فقد سجل النموذج 76.3% في اختبار الدفاع السيبراني المتقدم CyScenarioBench، كما حقق 89.6% في معيار CVE Rediscovery المعني بإعادة اكتشاف الثغرات الأمنية الحقيقية المنشورة عالمياً وتحليل بنيتها.
وفي مجال الأبحاث البيولوجية، سجل Mythos 5.2 نسبة 85.1% في اختبار تصميم البروتينات الموجهة خلال 24 ساعة، ما يفتح آفاقاً واسعة للبحث الدوائي وتطوير المركبات الحيوية.
وانطلاقاً من مبدأ الاستخدام المسؤول للقدرات الدفاعية المتقدمة، اعتمدت Anthropic نموذج وصول مؤسسي محكوم لنسخة Mythos 5.2؛ حيث توفر هذه البيئة حواجز أمان متقدمة تتيح للمؤسسات الدفاعية ومطوري البنى التحتية الحيوية استباق الثغرات البرمجية وحماية الشبكات دون تعريض المنظومة الرقمية لمخاطر الاستخدام المزدوج.
اكتشافات في الفيزياء والرياضيات وتصميم الأجهزة الإلكترونية
امتدت تجارب النموذجين إلى مجالات علمية وهندسية خارج البرمجة:
- الفيزياء النظرية: ساهم Fable 5.2 في حل مسألتين مفتوحتين تتعلقان بالثقوب السوداء والجاذبية الكمومية. وقد أتاحت Anthropic هذه النتائج كورقة بحثية أولية (Preprint) لفتح المجال أمام المجتمع الفيزيائي الدولي لتدقيق الحلول الرياضية المقترحة، في خطوة تعكس الشفافية في توظيف الذكاء الاصطناعي لحل المعضلات الكونية المعقدة.
- توثيق برهان مبرهنة فيرما: استخدم الفريق نحو 1000 وكيل لتوثيق برهان مبرهنة فيرما الأخيرة بلغة Lean خلال 30 ساعة فقط، محولين البرهان إلى صيغة رياضية رسمية قابلة للفحص الآلي الدقيق.
- تصميم الأجهزة الإلكترونية: صممت النماذج ثلاثة أجهزة إلكترونية عاملة من الصفر (مساعد صوتي منزلي، وسماعة USB، وجهاز محمول تفاعلي)، مؤكدةً قدرة النموذج على الربط بين المنطق البرمجي والمكونات المادية للعتاد.
- الروبوتات: قفز Fable 5.2 بنتيجته في بيئة محاكاة الروبوتات RoboDojo Sim إلى 64.9% (مقارنة بـ 27.6% للجيل السابق)، مما يبرز تطوره في تحليل المدخلات البصرية وإصدار أوامر الحركة اللحظية للروبوتات داخل بيئات العمل المتغيرة.
أسعار Claude Fable 5.2 وطرق الوصول إلى Mythos 5.2
خفضت Anthropic أسعار استخدام Fable 5.2 عبر واجهة البرمجة بنسبة 20% مقارنة بالإصدار السابق لتشجيع تبني بيئات الوكلاء المستقلين:
| نوع الاستخدام | سعر مليون رمز (Tokens) |
|---|---|
| رموز الإدخال Input | 8 دولارات |
| رموز الإخراج Output | 40 دولارًا |
| الإدخال في الوضع السريع Fast Mode | 16 دولارًا |
| الإخراج في الوضع السريع Fast Mode | 80 دولارًا |
ويقدم الوضع السريع (Fast Mode) سرعة توليد تصل إلى 2.5 مرة مقارنة بالوضع العادي مقابل ضعف التكلفة، وهو ما يخدم التطبيقات التي تتطلب استجابات فورية ومعالجة منخفضة الكمون.
ويتاح Fable 5.2 فورياً عبر واجهات البرمجة وقنوات Claude المعتمدة، بينما يظل Mythos 5.2 خاضعاً لسياسات الاعتماد الأمني للمؤسسات المؤهلة فقط.
الفرق بين Claude Fable 5.2 وClaude Mythos 5.2
| وجه المقارنة | Claude Fable 5.2 | Claude Mythos 5.2 |
|---|---|---|
| الجمهور المستهدف | المطورون والشركات والمستخدمون حول العالم | المؤسسات الأمنية والحكومية والبنى التحتية الحساسة |
| أبرز المجالات | البرمجة، والبحث العلمي، وهندسة النظم، وتنسيق الوكلاء | الأمن السيبراني الدفاعي، واكتشاف الثغرات، والأبحاث الحساسة |
| ضوابط الحماية | مرشحات أمان متوازنة للاستخدام العام والتطوير | ضوابط وحواجز وصول مؤسسية خاصة بالغة الصرامة |
| طريقة الوصول | متاح فورياً عبر واجهات البرمجة والمنصات | خاضع لبرنامج تدقيق واعتماد أمني مقيد |
Anthropic توسع قدرات Claude في المشروعات الهندسية والعلمية
يعكس إطلاق Fable 5.2 وMythos 5.2 تحول قطاع الذكاء الاصطناعي من مجرد نماذج مساعدة إلى أنظمة قادرة على قيادة وإنجاز مشروعات هندسية وبحثية طويلة المدى بشكل مستقل. فمن بناء أنظمة التشغيل وحل المسائل العلمية إلى تحقيق المركز الأول على مؤشرات الذكاء العالمية، تجمع Anthropic بين تعزيز الكفاءة والقدرات الحسابية، وفرض معايير حوكمة صارمة تضمن توظيف الذكاء الاصطناعي بمسؤولية وأمان.