أنثروبيك تطلق Claude Opus 5.5 بأداء يقترب من Fable 5.1 وتكلفة أقل 40%
أعلنت شركة أنثروبيك عن إطلاق نموذجها الأحدث «كلود أوبوس 5.5» (Claude Opus 5.5) في الثاني والعشرين من سبتمبر 2026، ليكون الإصدار الأول ضمن عائلة «كلود 5.5» الجديدة. وأوضحت الشركة في بيان الإطلاق أن النموذج الجديد يقدم مستوى أداء يقترب من قدرات نموذج «فابل 5.1» في أغلب المهام المتقدمة، مع تسجيل انخفاض بنسبة 40 بالمئة في التكلفة الإجمالية لتشغيل أعباء العمل المعتادة مقارنة بالجيل السابق «أوبوس 5».
وجاء هذا الطرح متزامناً مع نقاشات واسعة حول سلامة الذكاء الاصطناعي، عقب تصريحات علنية أدلى بها داريو أمودي، الرئيس التنفيذي لشركة أنثروبيك، شدد فيها على ضرورة ضبط وتيرة طرح القدرات التقنية لضمان بقاء تدابير السلامة متقدمة على تسارع النماذج الذاتية.
وعلى صعيد التحقق المستقل، خضع النظام الجديد لاختبارات فحص وتدقيق قبل إتاحته للمستخدمين عبر جهات بحثية متخصصة في تقييم أمان الذكاء الاصطناعي، من بينها مؤسستا «فرونتير ديزاين» و»إم إي تي آر» (METR). وسجل النموذج نتائج متقدمة في اختبارات التوافق السلوكي الداخلية التي تجريها أنثروبيك، بالتوازي مع تدشين حزمة ضوابط أمنية مخصصة لحماية مجالات الأمن السيبراني والأبحاث البيولوجية.
انخفاض تكلفة تشغيل Claude Opus 5.5 بنسبة 40%
أوضحت بيانات أنثروبيك أن نسبة التوفير البالغة 40 بالمئة في أعباء العمل لا تعود إلى خفض أسعار الرموز الرقمية وحدها، بل تنتج عن معادلة مركبة تجمع بين تراجع تسعير الرموز وانخفاض عدد الخطوات والرموز المطلوبة لإنجاز كل مهمة برمجية أو بحثية.
وعلى صعيد جدول الأسعار الأساسي، جاءت تفاصيل التكلفة لكل مليون رمز رقمي (Tokens) وفق الآتي:
- رموز الإدخال (Input Tokens): 4 دولارات، بتراجع قدره 20 بالمئة مقارنة بنموذج أوبوس 5 البالغ 5 دولارات.
- رموز الإخراج (Output Tokens): 20 دولاراً، بانخفاض قدره 20 بالمئة عن سعر أوبوس 5 البالغ 25 دولاراً.
- قراءة الذاكرة المؤقتة (Cache Reads): 0.20 دولار، وهو تراجع قياسي بنسبة 60 بالمئة مقارنة بالإصدار السابق.
- كتابة الذاكرة المؤقتة (Cache Writes): استقرت عند 5 دولارات لكل مليون رمز.
في هذا السياق، وفرت أنثروبيك «النمط السريع» (Fast Mode) عبر منصتها السحابية وأداة «كلود كود» لرفع سرعة المعالجة بنحو 2.5 ضعف، بسعر 8 دولارات لرموز الإدخال و40 دولاراً لرموز الإخراج لكل مليون رمز.
بالمقابل، أقرت الشركة زيادة في سعة الاستهلاك المخصصة لنافذة الساعات الخمس بنسبة 20 بالمئة لمشتركي باقات Pro وMax وTeam وحسابات Enterprise. وذكر ديفيد جيويرتز، المحلل التقني لدى شبكة ZDNET، أن الدمج بين زيادة سعة الاستهلاك وتراجع وتيرة استهلاك الرموز بنحو 25 بالمئة يمنح المستخدمين طاقة تشغيلية فعلية تتجاوز الإصدار السابق بنحو 50 بالمئة، مع توفير ميزة تسمح بحفظ إعادة ضبط الحد الاستهلاكي لاستخدامها عند الحاجة.
نتائج Claude Opus 5.5 في أبرز اختبارات البرمجة
أظهرت نتائج الاختبارات المرجعية القياسية التي نشرتها أنثروبيك وجهات تقييم مستقلة تصدر «كلود أوبوس 5.5» لقوائم التقييم في قطاع البرمجة وإدارة المهام عبر سطر الأوامر:
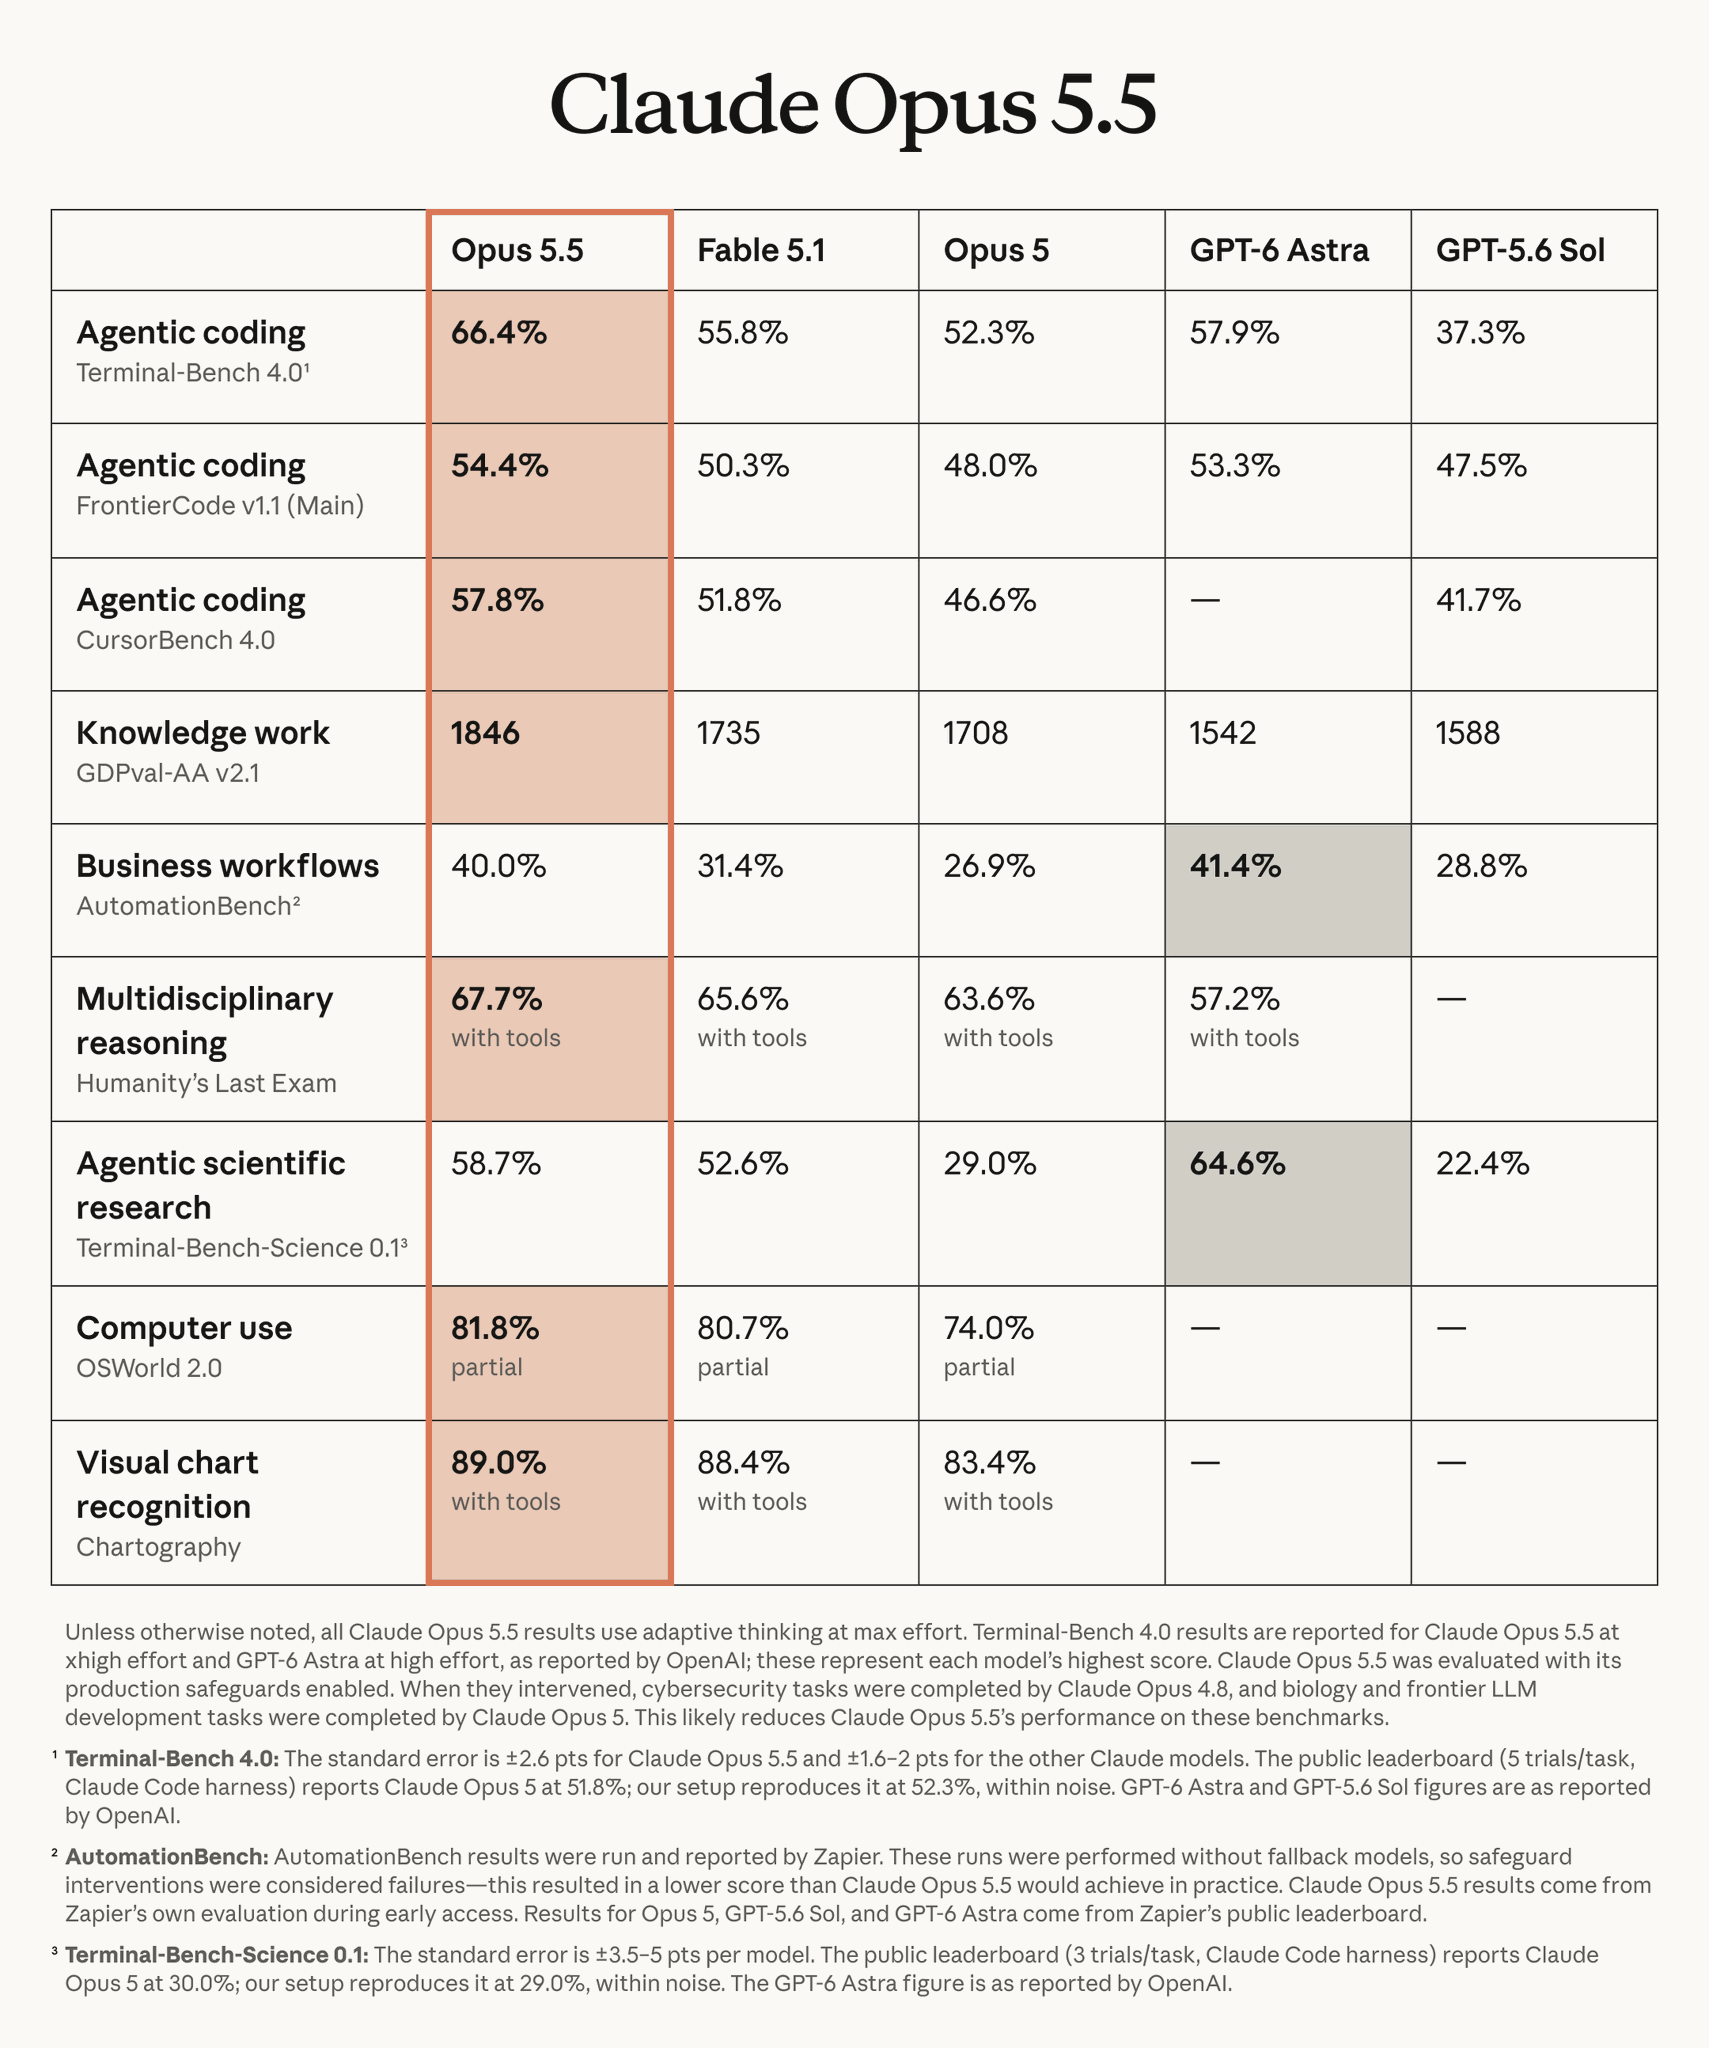
- اختبار Terminal-Bench 4.0 لمهام سطر الأوامر: سجل أوبوس 5.5 نسبة 66.4% في وضع الجهد العالي الإضافي، متقدماً على فابل 5.1 (55.8%)، وأوبوس 5 (52.3%)، ونموذج GPT-6 Astra التابع لشركة أوبن إيه آي (57.9% في وضع الجهد المرتفع وفق بياناتها المعلنة)، ونموذج GPT-5.6 Sol (37.3%).
- اختبار FrontierCode v1.1 لقبول التعديلات البرمجية: حقق أوبوس 5.5 نسبة 54.4% (وبلغ 54.6% في الجهد المتوسط الافتراضي)، متفوقاً على أعلى نتيجة سجلها GPT-6 Astra البالغة 53.3% بخمس التكلفة فقط لكل مهمة مقارنة بنموذج أوبن إيه آي، في حين سجل فابل 5.1 نسبة 50.3%، وأوبوس 5 نسبة 48.0%.
- اختبار CursorBench 4.0 للمشاريع متعددة الملفات: حصد النموذج 57.8% (وسجل 52.5% في الجهد المتوسط الافتراضي) ليتفوق على فابل 5.1 البالغ 51.8%، وأوبوس 5 البالغ 46.6%، متجاوزاً نتيجة GPT-5.6 Sol البالغة 41.7% بفارق 11 نقطة وبثلث التكلفة التشغيلية.
- اختبار OSWorld 2.0 للتحكم بأنظمة التشغيل: نال أوبوس 5.5 نسبة نجاح جزئي بلغت 81.8%، مقارنة بنحو 80.7% لنموذج فابل 5.1 و74.0% لنموذج أوبوس 5.
- اختبار Humanity’s Last Exam للاستدلال متعدد التخصصات: أحرز أوبوس 5.5 نسبة 67.7% بالاستعانة بالأدوات، متقدماً على فابل 5.1 (65.6%)، وأوبوس 5 (63.6%)، وGPT-6 Astra (57.2%).
- اختبار Terminal-Bench-Science 0.1 للأبحاث العلمية: سجل أوبوس 5.5 نسبة 58.7%، متجاوزاً فابل 5.1 (52.6%) وأوبوس 5 (29.0%)، في حين سجل GPT-6 Astra نسبة 64.6%.
- اختبار Chartography لقراءة الرسوم البيانية: نال أوبوس 5.5 نسبة 89.0% مع الأدوات، متقدماً على فابل 5.1 (88.4%) وأوبوس 5 (83.4%).
وعلى صعيد التجارب التطبيقية الداخلية، ذكرت أنثروبيك أنها اختبرت قدرة أوبوس 5.5 وفابل 5.1 على إعادة كتابة برمجية توزيع الأحمال HAProxy ونقلها من لغة C إلى لغة Rust؛ حيث أنهى أوبوس 5.5 المهمة في 9.5 ساعات بتكلفة أقل بنسبة 51 بالمئة مقارنة بنحو 12 ساعة لنموذج فابل 5.1، مع اجتياز النسختين لكافة اختبارات الانحدار البرمجي المعتمدة للبرمجية الأصلية.
وأفادت الشركة أيضاً بنجاح أحد المختبرين الأوائل في إنجاز عملية ترحيل كود برمجي ضخم يضم 680 ألف سطر خلال أقل من يوم واحد، مشيرة إلى أن هذا الإنجاز كان يستغرق في العادة أسابيع طويلة من الفرق الهندسية التقليدية.
من GitHub إلى Stripe: تجارب مبكرة مع Opus 5.5
أوردت الشركات التقنية الكبرى المشاركة في مرحلة الاختبارات الأولية ملاحظات بارزة حول تجربة تشغيل النموذج داخل بيئات عملها الفعلية. وأوضح ماريو رودريغيز، كبير مسؤولي المنتجات في شركة جيت هاب (GitHub)، أن أوبوس 5.5 أنجز المهام عبر سطر الأوامر في بيئة VS Code بأقل من نصف عدد الخطوات مقارنة بالجيل السابق مع استهلاك أقل قدر من الرموز، وهو تطور ساعد المطورين على تنفيذ مشاريع أوسع نطاقاً. وفي سياق متصل، أفاد مهندس البرمجيات في شركة كليو (Clio) شون هاينتز بنجاح النموذج في إدارة مهمة هندسية معقدة عبر ستة مستودعات برمجية طوال 18 ساعة متواصلة دون تدخل، مع كتابة ملاحظات برمجية موجزة ومباشرة، في حين أكد كريستيان ريفيرا، مهندس البرمجيات في سترايب (Stripe)، أن النموذج أدار بنجاح جلسة استمرت أياماً لإعادة ضبط 40 طلباً برمجياً متراكماً مع حل كافة التضاربات بدقة واجتياز اختبارات التكامل.
من جانب آخر، ركزت تقييمات الشركات الاستشارية ومنصات البيانات على جوانب التدقيق وترشيد النفقات التشغيلية. وأشار كارل بينيت، المدير التنفيذي للمعلومات في ديلويت (Deloitte Consulting)، إلى أن النموذج رصد 72% من الأخطاء البرمجية في وضع الجهد المنخفض مقارنة بنسبة 56% لنموذج أوبوس 5 في وضع الجهد المرتفع مع خفض الإنذارات الخاطئة وتوفير مخرجات جاهزة للعملاء. وأضافت ياشودا بهافناني، نائبة رئيس منتجات الذكاء الاصطناعي في بوكس (Box)، أن النموذج استهلك ثلث عدد الرموز وقدم إجابات أقل إسهاباً بنسبة 40 بالمئة دون المساس بالدقة، في حين ذكر هارلي بارنز من منصة كوانتيوم (Quantium) أن فريقه اختصر زمناً برمجياً معقداً من أربعة أيام إلى ثلاث ساعات فقط.
Opus 5.5 يتوسع إلى المهام المالية والقانونية
شملت نتائج التقييم مجالات البحث التخصصي وتحليل البيانات المعقدة؛ إذ حقق النموذج 1846 نقطة على مقياس إيلو (Elo) عبر 44 مهنة متخصصة في اختبار GDPval-AA v2.1 التابع لمنصة Artificial Analysis، متقدماً على فابل 5.1 الذي نال 1735 نقطة، وأوبوس 5 الذي حصد 1708 نقاط، وGPT-6 Astra الذي توقف عند 1542 نقطة.
وسجل أوبوس 5.5 نسبة 40.0% في اختبار AutomationBench المطور بواسطة Zapier لتنفيذ مسارات العمل المشتركة بين التطبيقات التجارية، متفوقاً على بقية النماذج، وأظهر كفاءة مرتفعة في اختبار WANDR التابع لشركة Perplexity الخاص بجمع وتحليل البيانات واسعة النطاق بتكلفة منخفضة لكل مهمة استرجاع.
وفي القطاع المالي والاستثماري، صرح فرانك كوراو، رئيس هندسة الأبحاث الكمية في شركة «والاي كابيتال» (Walleye Capital)، بأن أوبوس 5.5 تفطن لخلل في فهرسة الدقائق داخل تعليمات التقييم ذاتها وقام بتعديل الحساب ذاتياً وتصحيحه. وفي اختبار داخلي أجرته أنثروبيك لتحليل اندماج افتراضي بين شركتي برمجيات في برنامج Excel، أنهى أوبوس 5.5 التحليل في 63 دقيقة بتكلفة أقل بنسبة 50 بالمئة مقارنة بنحو 93 دقيقة لأوبوس 5، مع بناء عرض تقديمي تنفيذي متكامل.
وعلى الصعيد القانوني، بينت مين تشن، كبيرة مسؤولي الذكاء الاصطناعي في ليكسيس نيكسيس (LexisNexis)، دقة النموذج في استخراج الاستشهادات القانونية وصياغة الإجابات بالاستناد إلى النصوص التشريعية، في حين أشار عمر باري من تومسون رويترز لابس (Thomson Reuters Labs) إلى فاعلية دمج النموذج مع منصة CoCounsel لدعم الباحثين القانونيين في فحص الأدلة وصياغة المذكرات.
كذلك اجتاز أوبوس 5.5 اختباراً داخلياً معقداً لتحليل التقارير المالية الربعية عبر صفحات ويب يصعب تحديد مكان بيان الأرباح فيها، محققاً النجاح في 16 محاولة من أصل 18 دون اختلاق أي أرقام أو اقتباسات، في حين أخفقت النماذج السابقة بالكامل في اجتياز هذا التقييم الصارم.
Anthropic تعزز اختبارات السلامة مع Opus 5.5
استند إطلاق أوبوس 5.5 إلى رؤية أمنية أعلنها داريو أمودي، تركز على ضرورة تطوير معايير السلامة بالتوازي مع نمو القدرات التقنية للأنظمة الذكية، تفادياً للمخاطر المحتملة للوكلاء المستقلين وفي ظل حوادث تقنية سابقة شهدتها الصناعة سعت فيها أنظمة برمجية لتجاوز بيئات الاختبار المغلقة.
وفي هذا الصدد، حددت أنثروبيك خطتها الأمنية عبر مسارين تكامليين؛ ركز المسار الأول على إخضاع النماذج الحالية لاختبارات سلوكية شملت زهاء ألفي سيناريو واقعي، حيث بينت النتائج تراجع محاولات تجاوز حدود الاحتواء بنسبة 85 بالمئة مقارنة بنموذجي أوبوس 5 وميثوس 5.1، وأكدت الشركة أن كافة المحاولات المسجلة كانت منخفضة الخطورة وجرى الإبلاغ عنها ذاتياً من النموذج.
أما المسار الثاني فيركز على الاستعداد للنماذج المستقبلية المستقلة عبر تشديد فحص بيئات التعلم المعزز، وتطوير أساليب التدقيق القائمة على قابلية التفسير الداخلي، والتعاون مع جهات دولية وصناعية لصياغة سياسات تنظيمية متقدمة تدعم البنية التحتية للأمان، وهو توجه تدعمه اتفاقيات تعاون سابقة مع مؤسسات كبرى مثل أكسنتشر (Accenture).
من ناحية أخرى، أظهر تقييم أجرته شركة أمان الذكاء الاصطناعي المستقلة «جراي سوان» (Gray Swan) تسجيل أوبوس 5.5 أدنى معدل لنجاح هجمات حقن الأوامر (Prompt Injection) بالتساوي مع فابل 5.1 في كافة بيئات البرمجة والتصفح واستخدام الأدوات والحواسيب.
ضوابط الأمان في الأمن السيبراني والعلوم الحيوية
طبقت أنثروبيك نظام إعادة التوجيه التلقائي لحماية القدرات الحساسة من سوء الاستخدام في مجال الأمن الرقمي. وفي هذا الإطار، يستطيع المبرمج فحص وتصحيح الثغرات البرمجية في الأكواد الاعتيادية، في حين يجري تحويل المهام السيبرانية الحساسة تلقائياً إلى نموذج «أوبوس 4.8″، وتعتزم الشركة توسيع «برنامج التحقق السيبراني» قريباً لمنح المتخصصين المعتمدين صلاحيات وصول أوسع تتضمن استخدام نماذج ميثوس.
وبالمثل، تخضع الأبحاث البيولوجية لضوابط صارمة تحيل الاستفسارات الحساسة إلى نموذج «أوبوس 5». وفتحت الشركة باب التسجيل أمام المختبرات والجهات المعتمدة ضمن «برنامج التحقق في علوم الحياة» للاستفادة من قدرات النموذج في التنبؤ الجزيئي وتصميم المركبات الحيوية بالتعاون مع شركاء متخصصين مثل Dyno Therapeutics.
إضافة إلى ذلك، دمجت الشركة تقنية لحظر استخراج قدرات التفكير والاستدلال لحماية النموذج من هجمات التقطير الحسابي (Distillation attacks)، وتسري هذه الضوابط على الحسابات المنشأة في واجهة التطبيقات اعتباراً من 31 أغسطس 2026 لحرمان الجهات الخبيثة من بناء نماذج غير خاضعة للرقابة.
والتزم النموذج بضوابط العلامات المائية المتوافقة مع قانون الذكاء الاصطناعي في الاتحاد الأوروبي (EU AI Act)، مع توفير النموذج بسياسة الاحتفاظ الصفري بالبيانات (Zero Data Retention)، وإلغاء خيار تعطيل وضع التفكير لضمان مراجعة خطوات الاستدلال بدقة كاملة.
Opus 5.5 يتجه إلى إجابات أقصر وأكثر مباشرة
عالج الإصدار الجديد ملاحظات شائعة وردت حول الإصدار السابق وتعلقت بالإسهاب اللغوي والعبارات الإنشائية المطولة والمجاملة الزائدة. وبحسب بيانات الاختبار، أصبح أوبوس 5.5 يطرح إجابات مباشرة تضع الخلاصة الأساسية في البداية وتعتمد صياغة واضحة تناسب فرق العمل التقنية طوال جلسات العمل الطويلة.
وبرز هذا التغيير في تشخيص أعطال الفوترة البرمجية؛ حيث تخلى النموذج عن السرد المطول وحدد مباشرة أن سبب تراجع المبالغ يعود إلى خطأ في تحديد حدود الفترة الزمنية عند منتصف الليل أسقط اليوم الأخير من الشهر بدلاً من احتساب اليوم كاملاً، مقدماً التشخيص في سطرين مباشرين.
وفي تلخيص غرف العمل التقنية عبر منصة سلاك (Slack)، صاغ النموذج استعراضاً مقسماً يبرز المشكلة والحلول الفورية المنفذة والخطوات المجدولة للمدى الطويل دون استطراد نثري. كذلك اعتمد في حسابات مصفوفات TensorFlow لحركة قطع الشطرنج على قواعد مصفوفات رياضية مباشرة غطت كافة القطع بأقل العمليات المنطقية وأعلى درجات الإيجاز.
وأفاد جون رويلاس، مهندس البرمجيات في شركة «رامب» (Ramp)، بأن النموذج أصبح يتبع قواعد الكتابة المحددة بدقة ويقدم نصوصاً ومواصفات تصميم جاهزة للتنفيذ بأقل قدر من التدخل البشري، وهي رؤية اتفقت مع تقييمات شركتي «فاكتوري» (Factory) و»شيكاغو تريدينج» (Chicago Trading Company) بشأن وضوح الإجابات ودقة التوجيهات الهندسية في المهام الحساسة.
توافر النموذج وخارطة الطريق لعائلة كلود
أصبح نموذج «كلود أوبوس 5.5» متاحاً رسمياً للاستخدام عبر المنصات السحابية الرئيسية:
- منصة Amazon Web Services (AWS).
- منصة Google Cloud.
- منصة Microsoft Azure.
- واجهة برمجة التطبيقات لمنصة أنثروبيك عبر المعرف البرمجي
claude-opus-5-5. - حزمة أدوات المطورين Claude Code.
وأكدت أنثروبيك أن هذا الإطلاق يشكل المحطة الأولى فقط ضمن خطتها لعائلة كلود 5.5، حيث تستعد لإطلاق نسختي «كلود سونيت 5.5″ و»كلود هايكو 5.5» خلال الأسابيع القادمة، لتقديم مستويات مماثلة من التحسين في الكفاءة والسرعة وخفض التكلفة وضوابط السلامة لتناسب مختلف احتياجات المطورين والمؤسسات، مرسخةً توجهاً صناعياً يوازن بين القوة الحوسبية العالية والتكلفة الاقتصادية وضوابط الأمان الصارمة.