سبيس إكس إيه آي تكشف عن Grok 4.7 للبرمجة وتنافس النماذج الرائدة بنصف السعر
أعلنت شركة سبيس إكس إيه آي، في الحادي والعشرين من سبتمبر 2026، عن طرح نموذجها الجديد Grok 4.7، المصمم للبرمجة وهندسة البرمجيات والأعمال المعرفية المعقدة. وقالت الشركة في بيان الإطلاق إن النموذج يقدم سرعة تصل إلى ضعف سرعة النماذج المماثلة، مقابل نصف السعر، مع الحفاظ على هيكل التسعير الأساسي نفسه وسرعة الإصدار القياسي لـGrok 4.6.
ويعتمد الإصدار الجديد على تدريب مكثف بالتعلم المعزز الممتد، مع تركيز على المهام البرمجية والرياضية التي تتطلب فترات طويلة من التحليل. كما تقول الشركة إن Grok 4.7 أصبح أفضل في فحص مخرجاته وإدارة السياقات الطويلة، إلى جانب إدخال تحسينات جديدة على منظومة الأمان ومقاومة محاولات كسر الحماية.
وكان إيلون ماسك قد ذكر في تصريحات سابقة أن Grok 4.7 يضم نحو 2.1 تريليون معامل، مقارنة بنحو 1.5 تريليون في Grok 4.6. إلا أن إعلان سبيس إكس إيه آي الرسمي عن Grok 4.7 لم يذكر هذا الرقم تحديدًا، واكتفى بالإشارة إلى أن النموذج يعتمد على نموذج أساسي جديد وأكبر من الجيل السابق.
ترقية معمارية ضخمة وتدريب مكثف على المهام المعقدة
في هذا السياق، أوضحت سبيس إكس إيه آي أن Grok 4.7 يستند إلى نموذج أساسي أكبر من Grok 4.6، مع تدريب مكثف باستخدام التعلم المعزز على مجموعة واسعة من المسائل البرمجية والرياضية المعقدة.
وركز التدريب على المشكلات التي تتطلب ساعات متواصلة من العمل والتحليل، مع تحسين قدرة النموذج على التحقق من خطواته والتعامل مع السياقات الطويلة والمهام متعددة المراحل.
وتقول الشركة إن Grok 4.7 أصبح أكثر قدرة على اكتشاف الأخطاء ومراجعة مخرجاته أثناء تنفيذ المهام البرمجية، وهي آلية تستهدف رفع موثوقية النتائج عند التعامل مع المشاريع المعقدة.
ولا تحدد سبيس إكس إيه آي في إعلان الإطلاق رقمًا جديدًا لنافذة السياق الخاصة بـGrok 4.7، لذلك لا يمكن تأكيد أن النموذج الجديد يمتلك نافذة سياق تبلغ 500 ألف رمز. ويظل رقم 500 ألف رمز موثقًا في مواصفات Grok 4.6 الرسمية.
تكامل أصيل مع وكلاء Grok Bot والأنظمة المستقلة
من ناحية أخرى، حصل Grok 4.7 على تدريب أصلي لفهم بيئة Grok Bot والتعامل معها، وهي منظومة الوكلاء المستقلين التي كشفت عنها الشركة في الحادي عشر من أغسطس 2026.
وتعمل هذه المنظومة على مدار الساعة باعتبارها مجموعة من زملاء الذكاء الاصطناعي القادرين على استخدام حواسيب سحابية مخصصة وتنفيذ مجموعة من الإجراءات داخل التطبيقات والأدوات، مع إمكانية العمل على مهام تمتد لفترات طويلة.
وفي هذا الإطار، صممت سبيس إكس إيه آي Grok 4.7 للتعامل بصورة أفضل مع مهام العمل المعرفي والبرمجة، بما في ذلك استخدام الأدوات وتنفيذ سلسلة من الخطوات للوصول إلى نتيجة نهائية.
وتشمل هذه الاستخدامات العمل مع البرمجيات وبيئات التطوير والملفات والبيانات، إلى جانب تنفيذ المهام التي تتطلب تخطيطًا متتابعًا واستخدامًا مستمرًا للأدوات.
أداء متقدم في هندسة البرمجيات واختبار CursorBench 4.0
أظهرت نتائج التقييمات التقنية التي نشرتها سبيس إكس إيه آي قدرات قوية لنموذج Grok 4.7 في مهام كتابة وتطوير الشفرات البرمجية:
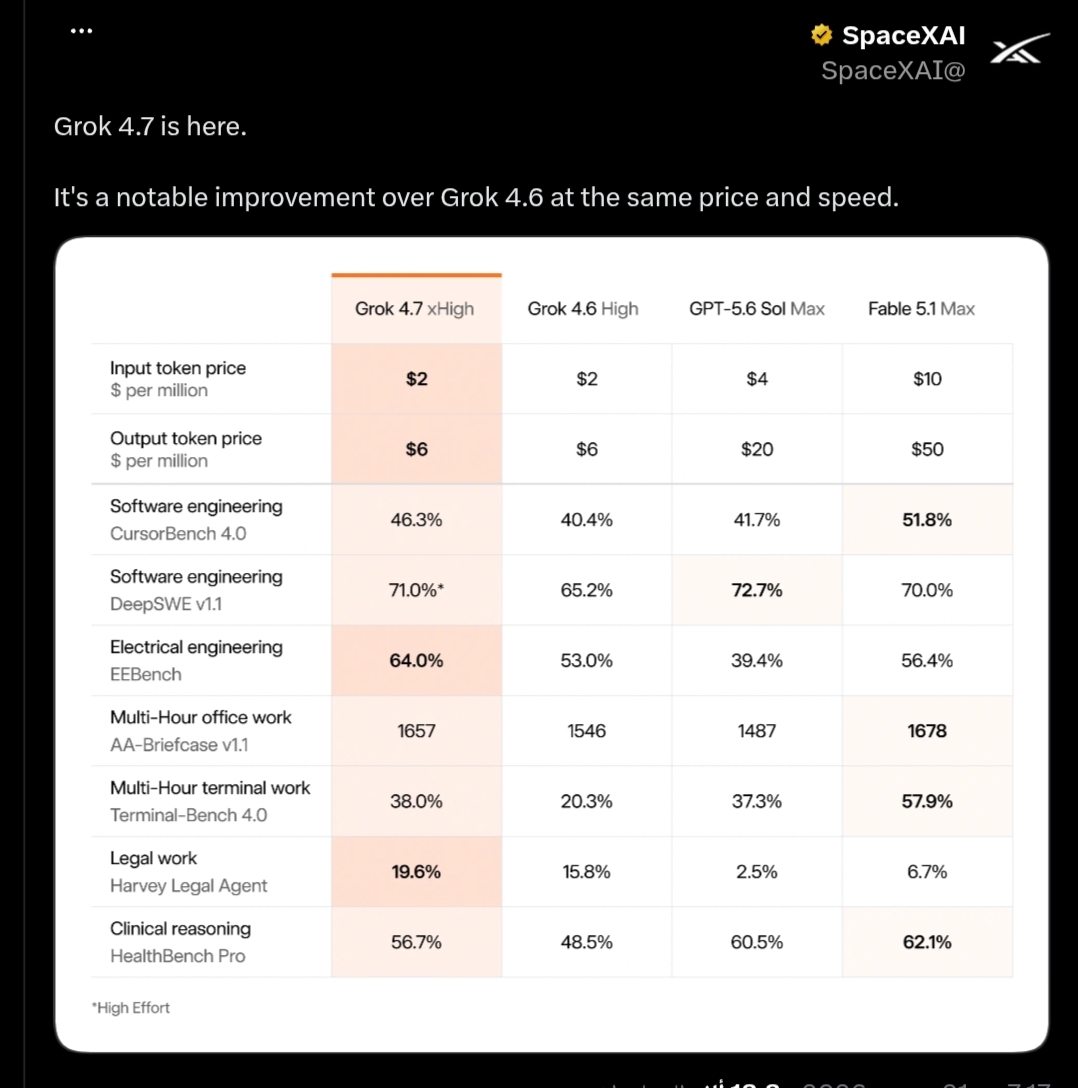
- اختبار CursorBench 4.0: سجل Grok 4.7 نسبة 46.3% في وضع الجهد الفائق لقياس تعديل وهندسة المشاريع المعقدة عبر ملفات متعددة، مقابل 40.4% لـGrok 4.6 و41.7% لـGPT-5.6 Sol و51.8% لـFable 5.1. وتظهر الصورة بصورة مختلفة عند النظر إلى التكلفة، إذ تشير بيانات المقارنة المتداولة إلى أن تكلفة المهمة الواحدة لـGrok 4.7 تبلغ نحو 11.95 دولارًا، مقابل تكاليف أعلى لبعض النماذج المنافسة.
- اختبار DeepSWE v1.1: سجل Grok 4.7 نسبة 71.0% في وضع الجهد العالي، متقدمًا على Fable 5.1 الذي سجل 70.0% وGrok 4.6 عند 65.2%، بينما اقترب من GPT-5.6 Sol الذي سجل 72.7%.
- اختبار هندسة البرمجيات EEBench: حقق Grok 4.7 نسبة 64.0%، مقابل 53.0% لـGrok 4.6 و39.4% لـGPT-5.6 Sol و56.4% لـFable 5.1.
- اختبار بيئة الأوامر الطرفية Terminal-Bench 4.0: سجل النموذج 38.0% مقابل 20.3% للإصدار السابق Grok 4.6، وهو ارتفاع يقارب 87% مقارنة بنتيجة الجيل السابق في الاختبار نفسه.
ريادة في تصنيفات Artificial Analysis والأعمال المهنية
أظهرت المقارنات المنشورة لنموذج Grok 4.7 أداءً قويًا أيضًا في مجموعة من الاختبارات التي تركز على الأعمال المهنية والمهام المعرفية الممتدة:
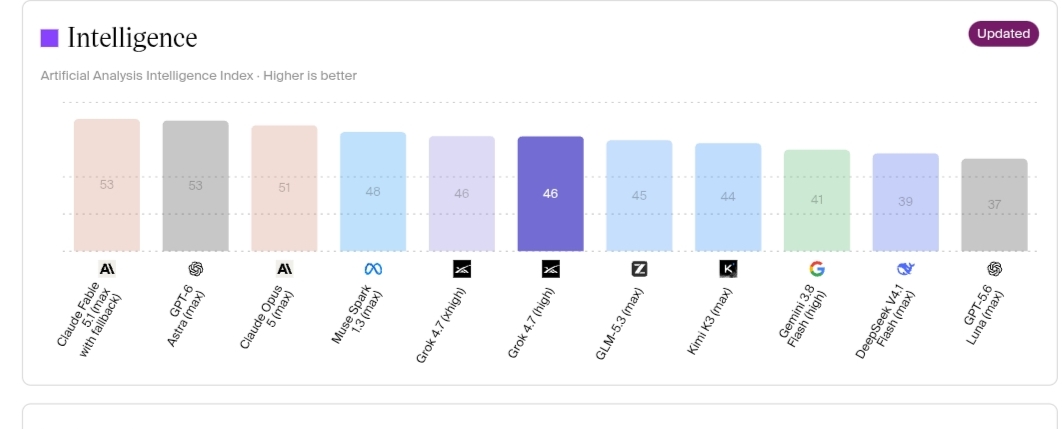
- مقياس AA Briefcase v1.1: سجل Grok 4.7 مجموع 1,657 نقطة في اختبار تنفيذ المهام المكتبية الممتدة، مقارنة بـ1,546 نقطة لـGrok 4.6 و1,487 نقطة لـGPT-5.6 Sol، بينما سجل Fable 5.1 نحو 1,678 نقطة.
- مقياس GDPval Elo: سجل Grok 4.7 نحو 1,695 نقطة لقياس تنفيذ الأعمال المهنية المتخصصة، مقابل 1,605 نقاط لـGrok 4.6 و1,542 نقطة لـGPT-6 Astra، بينما بلغ رصيد Fable 5.1 نحو 1,735 نقطة.
- اختبار المجال القانوني Harvey Legal: سجل Grok 4.7 نسبة 19.6%، مقابل 15.8% لـGrok 4.6 و6.7% لـFable 5.1 و2.5% لـGPT-5.6 Sol.
- اختبار التفكير الطبي السريري HealthBench Professional: أحرز النموذج 56.7%، ما يضعه ضمن مجموعة النماذج التي اختُبرت في هذا المجال.
بنية أمنية جديدة وتحسينات في السلامة السيبرانية والبيولوجية
إلى جانب الأداء البرمجي، ركزت سبيس إكس إيه آي على تحسين الجوانب الأمنية في Grok 4.7، خصوصًا في مواجهة محاولات كسر الحماية والطلبات التي قد تنطوي على استخدامات خطرة.
وفي اختبار السلامة البيولوجية لدى LatchBio، سجل Grok 4.7 نسبة 62.4%، في اختبار يستهدف تقييم قدرة النموذج على التعامل مع الطلبات ذات الاستخدام المزدوج ورفض الطلبات الخطرة مع الحفاظ على قدرته على مساعدة المستخدمين في التطبيقات العلمية المشروعة. وكانت سبيس إكس إيه آي قد أعلنت في وقت سابق عن نتائج Grok 4.6 في اختبارات السلامة البيولوجية، قبل أن ترفع النتيجة في الاختبار المخصص لـGrok 4.7.
وعلى صعيد الأمن السيبراني، سجل النموذج في اختبار HackerBench v0.3 نسبة مرور بلغت 3.3% فقط من الطلبات الخطرة، مع الحفاظ على القدرة على مساعدة الباحثين وفرق الأمن في المهام الدفاعية المشروعة. كما أعلنت الشركة عن برنامج للتعاون مع شركاء مختارين بهدف اختبار قدرات الفريق الأحمر وتحسين آليات الحماية الإلكترونية ومقاومة أساليب الاختراق الحديثة.
دعم واسع لبيئات التطوير وتكامل مع GitHub Copilot
بدأت سبيس إكس إيه آي في توسيع نطاق توزيع Grok 4.7 عبر مجموعة واسعة من أدوات البرمجة والمنصات المخصصة للمطورين.
وأعلنت GitHub في 21 سبتمبر 2026 عن إتاحة Grok 4.7 داخل GitHub Copilot، مع دعمه عبر مجموعة من الخطط، بما في ذلك Copilot Pro وPro+ وMax وBusiness وEnterprise. ويشمل التكامل بيئات وأدوات متعددة مثل Visual Studio Code وVisual Studio وCopilot CLI وCopilot cloud agent وJetBrains وXcode وEclipse، مع طرح تدريجي للخدمة.
وبالتوازي، أتاحت سبيس إكس إيه آي Grok 4.7 عبر بيئة Cursor، وأداة Grok Build، وواجهة برمجة التطبيقات Grok API، إلى جانب عدد من بوابات التوجيه ومنصات الحوسبة السحابية وأدوات تطوير البرمجيات. وتتيح هذه التوزيعات للمطورين استخدام النموذج مباشرة داخل بيئات العمل التي يعتمدون عليها بدلًا من الاقتصار على واجهة المحادثة التقليدية.
معادلة السعر مقابل الكفاءة والجدوى الاقتصادية
رغم القدرات الحسابية الكبيرة للنموذج، حافظت سبيس إكس إيه آي على هيكل تسعير أساسي يبلغ دولارين لكل مليون رمز إدخال وستة دولارات لكل مليون رمز إخراج، وهو السعر نفسه الذي تستخدمه الشركة لـGrok 4.6.
كما طرحت الشركة نسخة Grok 4.7 Fast التي توفر معدلًا مضاعفًا لإخراج الرموز مقابل ضعف السعر القياسي، لتلبية احتياجات التطبيقات التي تتطلب استجابة أسرع. وبالمقارنة، تعرض بيانات SpaceXAI سعر GPT-5.6 Sol عند نحو 4 دولارات لكل مليون رمز إدخال و20 دولارًا للإخراج، بينما يصل سعر Fable 5.1 إلى 10 دولارات للإدخال و50 دولارًا للإخراج.
وتعني هذه الفروق أن Grok 4.7 يأتي بتكلفة أقل من بعض النماذج المنافسة عند مقارنة أسعار الرموز، مع تقديم نتائج قوية في عدد من اختبارات البرمجة والعمل المعرفي. وبالنسبة للمطورين والشركات التي تعالج ملايين الرموز يوميًا، يمكن أن يصبح فرق السعر عاملًا مهمًا عند اختيار النموذج المناسب، خصوصًا في المشاريع التي تعتمد على الوكلاء والمهام البرمجية الممتدة.
إعادة صياغة بيئة العمل البرمجي ومستقبل الوكلاء التخصصيين
يمثل إطلاق Grok 4.7 خطوة جديدة في توجه سبيس إكس إيه آي نحو استخدام نماذجها في هندسة البرمجيات والأعمال المعرفية، بدلًا من الاقتصار على مهام المحادثة التقليدية.
ويجمع النموذج بين التدريب المكثف على المهام البرمجية، وتحسين قدرات استخدام الأدوات، والتكامل مع Grok Bot وبيئات التطوير، إلى جانب توفيره عبر GitHub Copilot وCursor وGrok API ومنصات أخرى.
وتشير نتائج الاختبارات المنشورة إلى أن Grok 4.7 يقدم تحسنًا واضحًا مقارنة بـGrok 4.6 في عدد من مهام البرمجة والعمل المعرفي، مع بقاء بعض النماذج المنافسة في الصدارة في اختبارات محددة.
أما العامل الآخر اللافت فهو السعر؛ إذ تضع سبيس إكس إيه آي Grok 4.7 عند دولارين للإدخال وستة دولارات للإخراج لكل مليون رمز، وهي تكلفة أقل من بعض النماذج الرائدة التي تقارنها الشركة به.
وبذلك، لا يقتصر إطلاق Grok 4.7 على زيادة قدرات نموذج لغوي جديد، بل يعكس توجهًا متزايدًا نحو دمج النماذج المتقدمة مباشرة في أدوات البرمجة والوكلاء وبيئات العمل اليومية، مع التركيز على المهام التي تتطلب ساعات من التحليل والتنفيذ المستمر.