تحديث DeepSeek-V4.1-Flash-1017: تحديث جديد لتحسين سرعة البرمجة وتقليل التكلفة
أعلنت شركة «ديب سيك» في السابع عشر من أكتوبر 2026 إطلاق تحديث جديد يحمل اسم DeepSeek-V4.1-Flash-1017، بهدف رفع كفاءة نموذج DeepSeek V4.1 Flash السابق الصادر في سبتمبر. هذا الإصدار ليس جيلاً برمجياً مستقلاً كلياً، بل جاء كنقطة فحص وترقية دورية ركزت على تسريع إنجاز الأعمال واختصار طول النصوص الناتجة، مع حصد درجات أعلى في اختبارات التقييم الرسمية. وحافظت الشركة على استقرار أسعار واجهات الاستدعاء السحابي والاحتفاظ باسم النموذج نفسه دون تغيير، إلى جانب طرح أوزان التحديث عبر منصة Hugging Face بترخيص MIT المفتوح بالكامل.
جاء هذا التطوير تلبية لرغبة المطورين في الحصول على وكلاء أذكياء يتولون مهام البرمجة والأتمتة بسلاسة ودون انتظار طويل. ورسخت هذه الخطوة مسار الشركة في طرح حلول عملية خفيفة التكلفة، عبر موازنة ذكية تجمع بين دقة الإجابة وسرعة التنفيذ.
DeepSeek-V4.1-Flash-1017: ما الذي يقدمه التحديث الجديد؟
يرتبط الرقم «1017» في اسم النموذج بتاريخ خروجه إلى النور في السابع عشر من شهر أكتوبر، وهو أسلوب درجت عليه الشركة لتمييز تحسيناتها المنتظمة دون حاجة لإعادة تسمية النموذج الأساسي. وتطلعت ديب سيك عبر هذه النسخة إلى تجاوز حدود الإجابات النظرية، والاقتراب خطوة إضافية نحو بناء المشاريع البرمجية الكاملة وتصحيح الأخطاء داخل بيئات التطوير الحية.
وعلى أرض الواقع، انصب جهد المهندسين على رفع كفاءة النموذج داخل سطر الأوامر (Terminal)، وبناء مستودعات الأكواد، وتنفيذ الإجراءات المتتابعة بدقة. وشملت التجارب المعلنة قدرة النظام على صياغة برمجيات متكاملة مثل ألعاب المتصفح والمشاهد التفاعلية ثلاثية الأبعاد انطلاقاً من طلبات نصية بسيطة. ورغم جاذبية هذه العروض التوضيحية، فإن بيئات العمل الحقيقية تفرض دوماً إجراء اختبارات مستقلة داخل الشفرات البرمجية للتثبت من سلامة البناء وتفادي الهفوات غير المقصودة.
إجابات أقصر ومهام أسرع: كيف يقلل التحديث استهلاك الرموز؟
تكمن الإضافة الأبرز في هذا التحديث في قدرة النموذج على إنهاء العمليات في وقت أقصر وصياغة إجابات أكثر تركيزاً مقارنة بنسخة سبتمبر. قد يبدو تقليص حجم الإجابة تفصيلاً عادياً، لكنه في عالم البرمجيات الذاتية يَصنع الفارق الحقيقي بين فاتورة باهظة وأخرى معقولة؛ نظراً لأن تكلفة رموز المخرجات تفوق تكلفة رموز المدخلات بعدة أضعاف.
وتظهر أهمية هذا التحسين عند استخدام النموذج في مهام تتطلب خطوات متتابعة، مثل كتابة الأكواد واختبارها وإصلاح الأخطاء. فكلما قلّ عدد الرموز التي يحتاج النموذج إلى إنتاجها لإنجاز المهمة، انخفضت التكلفة المحتملة واختصر الوقت اللازم للحصول على النتيجة. لكن تقليل طول الإجابات وحده لا يكفي؛ إذ تظل الفائدة الحقيقية مرتبطة بقدرة النموذج على إنجاز المهمة بدقة دون التضحية بجودة النتائج.
نتائج الاختبارات: كيف تطور أداء DeepSeek-V4.1-Flash-1017 في البرمجة؟
أظهرت بطاقة التحديث الرسمية المنشورة على منصة Hugging Face تحسناً شمل كافة الاختبارات المعتمدة، مع تسجيل قفزات واضحة في ميادين كتابة الأكواد والتعامل مع سطر الأوامر، استناداً إلى أطر تقييم دقيقة كشفت الفوارق بين النسختين.
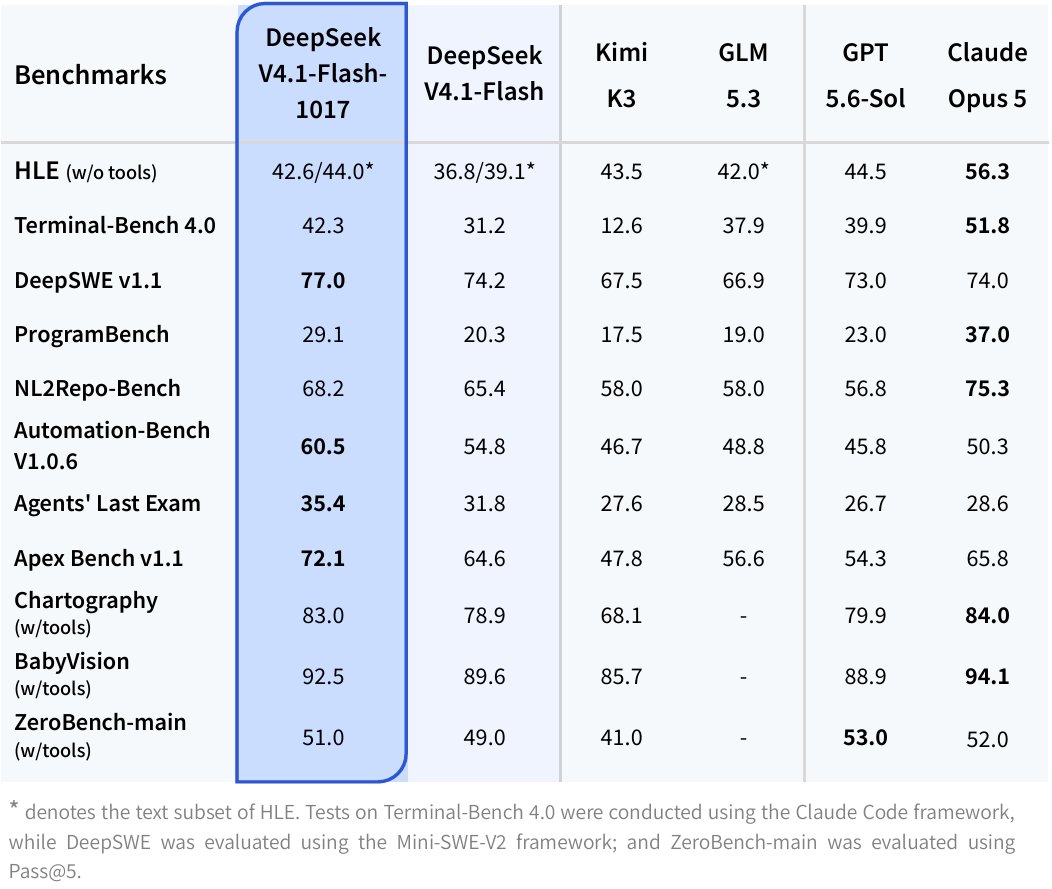
جاءت أرفع قفزة رقمية في اختبار Terminal-Bench 4.0 المتخصص في قياس قدرة الوكلاء على العمل داخل بيئات الطرفية وسطور الأوامر؛ إذ صعدت النتيجة من 31.2 إلى 42.3 نقطة، بزيادة لافتة بلغت 11.1 نقطة. يعكس هذا التحسن قدرة أعلى على تنصيب حزم البرمجة، وفحص مسارات الملفات، واستكشاف الأخطاء ذاتياً. وجرى هذا الفحص عبر بيئة Claude Code التابعة لشركة أنثروبيك، وهو تفصيل جوهري لأن أسلوب استدعاء الأدوات يترك أثراً مباشراً على الدرجات المسجلة.
وفي الاتجاه نفسه، سجل النموذج 77.0 نقطة في اختبار DeepSWE v1.1 المعني بحل المشكلات البرمجية المعقدة في مستودعات غيت هاب، صعوداً من 74.2 نقطة. وارتفعت نتيجة اختبار ProgramBench بنحو 8.8 نقطة لتبلغ 29.1، ورافقتها زيادة في اختبار بناء المستودعات انطلاقاً من الأوامر المكتوبة باللغة الطبيعية (NL2Repo-Bench) ليصل إلى 68.2 نقطة. كذلك شهد اختبار الأتمتة Automation-Bench صعوداً إلى 60.5 نقطة، وارتفع تقييم Apex Bench إلى 72.1 نقطة.
وامتدت التحسينات إلى المهام البصرية التي تعتمد على الأدوات المساعدة؛ إذ ارتفعت علامة النموذج في اختبار فهم الرسوم والمخططات Chartography لتصل إلى 83.0 نقطة، وصعد في اختبار تحليل الصور BabyVision إلى 92.5 نقطة. هذه النتائج تفتح الباب أمام قراءة لقطات الشاشات الرقمية واستيعاب واجهات المستخدم دون الحاجة لنموذج بصري منفصل.
أداء النموذج أمام المنافسين: الأتمتة والمهام النظرية
تقتضي الأمانة الصحفية النظر إلى هذه الأرقام بحيادية تامة؛ إذ وضعت ديب سيك نموذجها في مقارنة مع عمالقة الذكاء الاصطناعي، وعلى رأسهم Claude Opus 5 وGPT-5.6 Sol، إضافة إلى نماذج صينية بارزة مثل GLM-5.3 وK3.
في ميدان كتابة الأكواد والتعامل مع الوكلاء، نال تحديث 1017 تفوقاً مستحقاً في اختبار DeepSWE v1.1 بحصده 77.0 نقطة، متجاوزاً Claude Opus 5 الذي حقق 74.0 نقطة، وGPT-5.6 Sol الذي توقف عند 73.0 نقطة. وحاز النموذج الصدارة في اختبارات الأتمتة المتقدمة، مبرهناً على جدارته في إنجاز الأعمال التطبيقية وسرعة تصحيح الأكواد.
رغم ذلك، احتفظ Claude Opus 5 بتفوق واضح في اختبارات الاستدلال الأكاديمي والمنطق المعرفي المعقد. ففي اختبار Humanity’s Last Exam (HLE) الخالي من الأدوات، أحرز Opus 5 نحو 56.3 نقطة، في حين استقر رصيد ديب سيك عند 42.6 نقطة للنسخة العامة و44.0 نقطة للمسار النصي. وتقدم نموذج أنثروبيك في توليد مشاريع الأكواد المعقدة (NL2Repo-Bench) بنتيجة 75.3 نقطة مقابل 68.2 لديب سيك، وتصدر اختبار BabyVision البصري بنتيجة 94.1 نقطة. وفي الوقت نفسه، حافظ GPT-5.6 Sol على تقدمه في اختبار ZeroBench-main بنتيجة 53.0 مقابل 51.0 لنقطة الفحص الصينية.
تدل هذه المقارنة المتزنة على أن تحديث Flash 1017 بات سلاحاً فعالاً لمهام البرمجة الروتينية وتشغيل الأوامر الآلية، لكنه لا يزال يقف خلف النماذج الرائدة في المسائل العلمية المعقدة والاستنتاجات النظرية العميقة.
الفارق الجوهري مع إصدار V4 Pro القديم
يكتسب فحص النموذج في مواجهة إصدار الشركة السابق DeepSeek V4 Pro دلالة بالغة الأهمية لأصحاب المشاريع القائمة. ففي التجارب العملية التي شملت كتابة دوال التحليل البرمجي واستخلاص البيانات وتنفيذ استدعاءات الأدوات المتزامنة، حقق تحديث 1017 فارقاً شاسعاً في السرعة والتكلفة.
استطاع تحديث 1017 إنهاء مهمة برمجية معقدة في نحو 88 ثانية فقط، في حين استغرقت المهمة ذاتها أكثر من عشرين دقيقة عبر نموذج V4 Pro. أضف إلى ذلك أن إصدار 1017 يدعم الرؤية البصرية الأصلية وقراءة الرسوم البيانية، وهي ميزة يفتقر إليها V4 Pro بالكامل. ومع انخفاض تكلفة التشغيل بنسب تراوح بين أربعة إلى أحد عشر ضعفاً لصالح التحديث الجديد، أصبح الاحتفاظ بالنموذج القديم مقتصراً على حالات نادرة تثبت فيها الاختبارات الخاصة فائدة حصرية له.
ضغط ذاكرة التخزين المؤقت: كيف تعمل الآلية الهندسية؟
عنونت ديب سيك تقريرها التقني بعبارة واضحة: «دفع حدود ضغط ذاكرة السياق المؤقتة» (Pushing the Limits of KV Cache Compression). يعتمد النموذج على هيكل يحوي 552 مليار معلمة إجمالية بنظام خليط الخبراء، وتنشط منها 8 مليارات معلمة فقط لاستقبال الأوامر و16 مليار معلمة أثناء كتابة المخرجات.
ذاكرة السياق المؤقتة (KV Cache) هي المساحة التي تحتفظ بحسابات الكلمات السابقة لتجنب إعادة حسابها مع كل خطوة جديدة. ومع تشغيل سياق ضخم يبلغ مليون رمز، كانت هذه الذاكرة تبتلع سعة المعالجات الرسومية وتعرقل العمل. وبفضل تقنيات الضغط المبتكرة، استقر عمل هذا السياق المليوني دون استنزاف الموارد، مع توفير قدرة على إنتاج ردود تتراوح بين 256 ألف رمز و384 ألف رمز كحد أقصى، لخدمة المطورين الذين يتعاملون مع ملفات أكواد كاملة ومحادثات ممتدة.
أسعار API وأدوات البحث: ما الذي يحتاج المطور إلى معرفته؟
لم تطرأ أي زيادة على أسعار واجهات الاستدعاء البرمجية؛ فالشركة حافظت على تسعيرتها الرسمية دون أي تعديل، مقسمة اليوم بين ساعات هادئة وساعات ذروة. وحددت الأسعار في الفترات الهادئة كالتالي:
- 0.15 دولار لكل مليون رمز لمدخلات الذاكرة الجديدة غير المحفوظة (Cache Miss).
- 0.003 دولار لكل مليون رمز لمدخلات الذاكرة المخبأة مسبقاً (Cache Hit).
- 0.60 دولار لكل مليون رمز لنصوص المخرجات الناتجة.
في المقابل، تتضاعف هذه الرسوم بالكامل خلال فترات الذروة المحددة بالتوقيت العالمي (UTC) بين الساعة 01:00 والساعة 04:00 صباحاً، وبين الساعة 06:00 والساعة 10:00 صباحاً من الإثنين إلى الجمعة. وترافق هذا الإطلاق مع فتح أداتين جديدتين للوكلاء: واجهة البحث (Search API) لجلب نتائج الويب، وواجهة الجلب (Fetch API) لسحب صفحات المواقع وتنسيقها كنصوص ماركداون واضحة، بتكلفة 0.75 دولار لكل ألف استدعاء ناجح، مع عروض تجريبية مجانية حتى نهاية أكتوبر 2026.
إرشادات عملية للمطورين والتشغيل المحلي
يستمر استخدام المعرف البرمجي الحالي deepseek-flash لاستدعاء النموذج دون حاجة لتغيير سطر برمجي واحد في المشاريع القائمة. ويدعم النظام خياري التفكير المتأني (Thinking Mode) والرد الفوري السريع، مع إمكانية تعديل كثافة التفكير عبر مستويات متعددة.
وحول نشر الأوزان المفتوحة، طرحت ديب سيك ملفات النموذج في 48 ملفاً بصيغة safetensors وبتكميم رقمي دقيق FP8 عبر Hugging Face تحت رخصة MIT. ورغم أن هذه الخطوة تفتح المجال للدراسة والتعديل، فإن حجم النموذج الضخم يستلزم بنية تحتية سحابية وبطاقات رسومية احترافية لتشغيله بنجاح.
ومن الملاحظات التقنية البارزة غياب قالب المحادثة الجاهز بصيغة Jinja عن حزمة الإصدار. وعوضاً عن ذلك، وفرت الشركة كوداً بلغة بايثون داخل مجلد الترميز، بالتوازي مع حزمة أدوات متقدمة بلغة رَست (Rust) تحمل اسم deepseek-recipe لتنسيق الأوامر وفك الرموز بدقة، مع توصية بترقية منصة DeepSeek Harness إلى الإصدار v0.2.1-rc.1.
إرشادات استخدام النموذج وتوجيهه بصورة آمنة
يقتضي تشغيل الوكلاء المستقلين فرض بيئات معزولة وآمنة (Sandboxes)؛ لحماية الملفات الأساسية وتجنب تسريب المفاتيح السرية. ومن المفيد أيضاً تجنب إغراق سياق المحادثة ببيانات هامشية قد تصرف انتباه النموذج، بل ينبغي تحديد الملفات المعنية وصياغة طلبات واضحة وقابلة للاختبار.
ومن زاوية التوجيه الذكي (Model Routing)، الأفضل جعل Flash 1017 خيار العمل الافتراضي لتنفيذ الأكواد وحل المشكلات واستخلاص البيانات، مع تحويل المعضلات المنطقية النادرة والأسئلة الأكاديمية الصعبة إلى نماذج رائدة مثل Claude Opus 5 لضمان أعلى درجات الدقة.
DeepSeek-V4.1-Flash-1017: هل يستحق التحديث التجربة؟
يمثل تحديث DeepSeek-V4.1-Flash-1017 خطوة إضافية لتحسين أداء النموذج في المهام البرمجية والأعمال التي تعتمد على الوكلاء الذكيين، مع التركيز على سرعة التنفيذ وتقليل طول المخرجات. وتُظهر نتائج الاختبارات المنشورة تحسنًا في عدد من المهام مقارنة بالإصدار السابق، وإن كان تقييم فائدته العملية يظل مرتبطًا بطبيعة العمل والنتائج التي يحققها في الاستخدام الفعلي.
ومع استمرار الأسعار المعلنة دون تغيير وإتاحة أوزان النموذج بترخيص MIT، قد يكون التحديث خيارًا مناسبًا للمطورين الذين يبحثون عن حل أقل تكلفة لتنفيذ المهام المتكررة. لكن اختيار النموذج الأنسب يظل مرهونًا بموازنة جودة النتائج وسرعة الإنجاز وتكلفة التشغيل، بدل الاعتماد على نتائج الاختبارات وحدها.