جوجل تطلق Gemini 3.8 Live وGemini 3.8 Live Extended Thinking للمحادثات المباشرة والتفكير المتزامن
أعلنت شركة جوجل ديب مايند إطلاق نسختين جديدتين من نماذج التخاطب الصوتي الحي، هما Gemini 3.8 Live ونسخة Gemini 3.8 Live Extended Thinking، بهدف نقل تجربة التفاعل مع الذكاء الاصطناعي نحو آفاق غير مسبوقة تبتعد عن البطء والجمود، وتمنح المستخدمين والشركات وكلاء صوتيين قادرين على إدارة حوارات عميقة وتنفيذ عمليات رقمية معقدة عبر الصوت فقط دون انقطاع.
أفادت البيانات الرسمية الصادرة عن الشركة بأن هذه المنظومة تنتمي إلى عائلة نماذج Gemini 3، وتعتمد بصورة مباشرة على بنية نموذج Gemini 3 Pro. ركز مهندسو التطوير على خفض زمن الاستجابة إلى أدنى المستويات الممكنة وتقليص النفقات التشغيلية أثناء معالجة التدفقات الصوتية والبصرية في الزمن الحقيقي، الأمر الذي يضع هذه الأدوات في صدارة الحلول الموجهة لبناء تطبيقات المحادثة الحية واسعة النطاق.
الانتقال من الأنظمة المتسلسلة إلى المعالجة الصوتية الأصيلة
ظلت الأنظمة الصوتية السابقة تعتمد على تركيبة تقليدية متسلسلة تبدأ بنسخ الصوت إلى نصوص عبر تقنيات التعرف على الكلام، ثم تمرير النصوص إلى النماذج اللغوية لتحليلها، قبل إعادة تحويل الرد النصي إلى صوت اصطناعي. هذا المسار المتسلسل كان يتسبب في ضياع نبرة الصوت، التردد، العاطفة، والتفاصيل غير اللفظية التي يحملها الصوت البشري عند كل مرحلة انتقال بين تلك المحطات المنفصلة.
بالمقابل، يعتمد نموذج Gemini 3.8 Live على بنية متعددة الوسائط تعمل بصورة أصيلة ومباشرة من الصوت إلى الصوت (Native Speech-to-Speech). يستقبل النموذج تدفقات الصوت مباشرة ويتعامل معها كوحدات متكاملة، الأمر الذي يحفظ ملامح النبرة والمشاعر وسرعة الإلقاء والسياق الإنساني الدقيق.
صرح توم أويانغ، كبير المهندسين في جوجل ديب مايند، بأن النماذج الحديثة تمثل تقدمًا ملموسًا في الحوار الحي، مشيرًا إلى أن دمج التفكير الموازي يجعل التواصل الصوتي مع الآلة تجربة طبيعية وسلسة إلى أبعد الحدود. وأردفت ماليني جاغاناثان، عضو الفريق التقني لنماذج الصوت في الشركة، بأن هذا الجيل تجاوز معضلة الانتظار المصطنع، وأصبح قادرًا على مجاراة سرعة التفكير البشري أثناء تبادل الحديث دون أي تأخير مزعج.
Gemini 3.8 Live Extended Thinking.. التفكير المتزامن والتحدث في الوقت نفسه
ينفرد نموذج Gemini 3.8 Live Extended Thinking بقدرته على التفكير والتحدث في اللحظة ذاتها، حيث يجمع بين الاستيعاب اللحظي للحوار والقدرة على خوض استدلالات منطقية متسلسلة في الخلفية. يستعين النموذج بإشارات لفظية طبيعية مثل عبارة «دعني أتحقق من ذلك»، ثم يسرد خطوات عمله للمستخدم عبر تعليق صوتي مباشر أثناء معالجة العمليات المتشعبة خلف الكواليس، دون أن يضطر المستخدم إلى الانتظار في صمت أو إعادة طرح سؤاله.
في هذا الإطار، يسمح النموذج للمطورين بضبط إعدادات التفكير (Configurable Thinking) للتحكم في عمق التحليل وسرعته تبعًا لنوع المهمة، سواء كانت استفسارًا بسيطًا يتطلب ردًا خاطفًا، أو مسألة حسابية وبرمجية تتطلب خطوات تدقيق متعددة. هذا الأسلوب يبني جسرًا متينًا من التفاعل المستمر بين الإنسان والآلة، ويقضي على التوقفات الصامتة التي كانت تفسد انسيابية الحوار الصوتي في السابق.
صدارة مؤشرات الأداء واختبارات الكفاءة العالمية
أظهرت نتائج التقييمات المستقلة تفوقًا واضحًا لهذه المنظومة على منصات قياس الأداء الصوتي للذكاء الاصطناعي. وفقًا لبيانات منصة التحليلات الدولية Artificial Analysis، حصد نموذج Gemini 3.8 Live Extended Thinking المركز الأول عالميًا على مؤشر جودة الصوت من طرف إلى طرف (Speech to Speech Quality Index) مسجلًا 82.6 نقطة.
في هذا السياق، سجل النموذج مستويات متقدمة في إنجاز مهام الوكلاء الأذكياء، حيث حقق نسبة 68.6% على مقياس τ-Voice المخصص لاختبار قدرة النماذج على إدارة العمليات الحوارية التفاعلية، ونسبة 35.1% على مقياس τ-Voice-banking التابع لشركة سييرا والمخصص لتقييم العمليات المصرفية والمالية الدقيقة. كما نال النموذج نسبة 97.7% في اختبارات التفكير والاستنتاج على مؤشر Big Bench Audio، محافظًا في الوقت عينه على كلفة تشغيلية منافسة لبقية النماذج الرائدة في السوق.
أما النسخة القياسية Gemini 3.8 Live، فقد نالت المركز الثاني في تفضيلات المستخدمين عبر منصة Speech Agent Arena، بفضل توازنها الفريد بين خفة الوزن وسرعة الاستجابة وانخفاض كلفة الاستخدام للشركات التي تبني تطبيقات ذات كثافة استخدام عالية. بالإضافة إلى ذلك، تجاوزت النماذج حاجز الكفاءة على مقياس EVA-Bench التابع لشركة سيرفيس ناو (ServiceNow)، من خلال الموازنة الدقيقة بين دقة إنجاز المهام وجودة التفاعل الحواري أثناء سير العمل المعقد داخل بيئات المؤسسات الكبرى.
قدرات متزامنة: الرؤية المباشرة ودعم 97 لغة واستدعاء الأدوات
يمتلك Gemini 3.8 Live القدرة على معالجة المدخلات البصرية في الزمن الفعلي بالتزامن مع الصوت، الأمر الذي يمنح المحادثات سياقًا بصريًا متكاملًا. يستطيع النموذج تحليل المشاهد التي يراها المستخدم عبر الكاميرا والتعليق عليها فوريًا؛ وظهر ذلك في عروض حية تضمنت مرافقة الموظفين الجدد خلال فترات التدريب والإجابة عن استفساراتهم بالاعتماد على المحيط البصري المباشر، فضلًا عن مشاركة النموذج في لعب الشطرنج والتفاعل صوتيًا مع تحركات الرقعة اللحظية بدقة لافتة.
وفي تجربة متقدمة أخرى، استطاع نموذج Gemini 3.8 Live Extended Thinking تحويل رسومات ورقية وتخطيطات أولية مصحوبة بتوجيهات صوتية سريعة إلى واجهات برمجية تفاعلية مبنية بلغة React، إلى جانب قدرته على تنظيم جداول حجوزات معقدة وتنسيق المواعيد وبناء خطط أعمال متكاملة واستراتيجيات تسويقية بمجرد الحديث معه.
علاوة على ذلك، يدعم النموذج التعرف التلقائي والتنقل السلس بين 97 لغة ولهجة عالمية مختلفة أثناء الحوار الواحد دون الحاجة إلى إعادة ضبط الإعدادات، مع الحفاظ على وضوح النبرات واللهجات المحلية بدقة. ويمتاز النموذج بقدرة فائقة على التقاط الأرقام والحروف والرموز المعقدة، مثل أرقام المطالبات التأمينية، ورموز التحقق الثنائية، والبيانات التقنية الصعبة، متفاديًا الأخطاء التي كانت تحدث في الأنظمة السابقة.
يمتلك النموذج خاصية استدعاء الدوال البرمجية في الخلفية (Asynchronous Function Calling)، بالإضافة إلى خاصية send_client_content التي تسمح بإدخال سياقات وبيانات حديثة إلى الجلسة دون إجبار المستخدم على بدء دور حواري جديد أو مقاطعة تدفق الحديث. وتتكامل هذه القدرات مع خاصية الصوت التفاعلي المسبق (Proactive Audio)، التي تسمح للنظام بالاستماع في هدوء، والتدخل بصوته فقط عند توجيه الحديث إليه مباشرة أو عند وقوع حدث بصري أو صوتي ذي صلة يستدعي تنبيه المستخدم.
بيئة المطورين والشركاء والتسعير التنافسي
حددت جوجل ديب مايند خطة تسعير منافسة لنماذج Gemini 3.8 Live عبر واجهة Live API، حيث تبلغ كلفة الدقيقة الواحدة لمدخلات الصوت 0.005 دولار، بينما تبلغ كلفة الدقيقة الواحدة لمخرجات الصوت 0.018 دولار (استنادًا إلى تسعير يعادل 3 دولارات لكل مليون رمز للمدخلات، و12 دولارًا لكل مليون رمز للمخرجات).
أوضحت الشركة تعاونها مع منصات رائدة متخصصة في البنية التحتية للبث المباشر والوسائط المتعددة، من بينها Agora وLiveKit وPipecat وLangChain وVercel وFishjam وVision Agents. تتكفل هذه المنصات بإدارة حركة البيانات والوسائط المعقدة خلف الكواليس، في حين يتفرغ المطورون لبناء التجارب التفاعلية وتصميم وكلاء صوتيين متخصصين لخدمة مختلف القطاعات.
أعربت شركات عالمية مثل Salesforce وGenspark وLumeris عن تبنيها لهذه النماذج، مشيدة بسرعة الاستجابة ودقة استدعاء الأدوات والأنظمة الخارجية أثناء الحديث المستمر. كما تضم منظومة الصوت للمطورين نماذج متكاملة أخرى، منها نموذج Gemini 3.5 Live Translate للترجمة الصوتية المباشرة بين أكثر من 70 لغة، ونموذج Gemini 3.1 Flash TTS لتوليد النبرات الصوتية الاصطناعية، ونموذج Lyria 3.5 المخصص لتأليف الإنتاج الموسيقي الاحترافي.
خريطة التوفر والتكامل عبر التطبيقات والأنظمة
بدأت جوجل إتاحة النماذج الجديدة وفق خريطة انتشار واسعة تشمل عدة مسارات:
- قطاع المطورين: عبر واجهة Gemini API ومنصة Google AI Studio للبدء في بناء التطبيقات وتجربة الوكلاء الأذكياء فورًا.
- قطاع المؤسسات والشركات: عبر معاينة خاصة في Gemini Enterprise، مع التحضير لإطلاقها قريبًا ضمن منصة Gemini Enterprise for Customer Experience لإدارة مراكز خدمة العملاء والعمليات التفاعلية الضخمة.
- عموم المستخدمين والمشتركين:
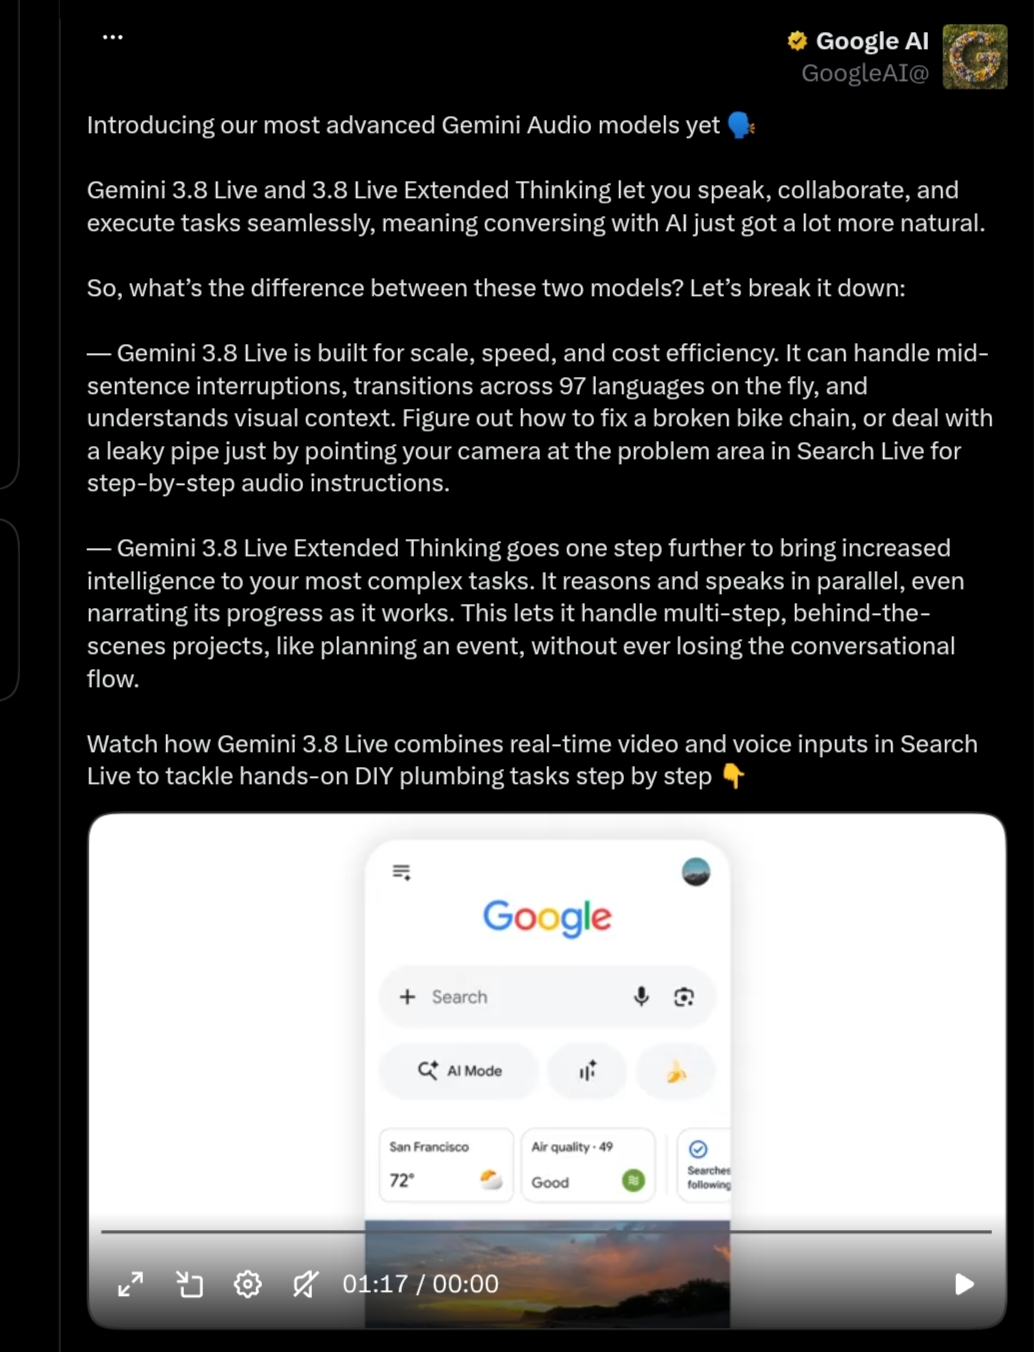
- يتاح نموذج Gemini 3.8 Live لجميع المستخدمين داخل محرك البحث المباشر (Search Live) لحل المشكلات التقنية خطوة بخطوة، وكذلك داخل تطبيق Gemini Live.
- يتاح نموذج Gemini 3.8 Live Extended Thinking لمشتركي باقات Google AI Pro وGoogle AI Ultra ولعملاء قطاع الأعمال في Google Workspace، حيث يندمج بعمق داخل مستندات Docs Live، وبريد Gmail Live، وتطبيق تدوين الملاحظات Keep Live لمساعدتهم في إنجاز الأعمال اليومية المعقدة بصوتهم فقط ودون الحاجة إلى كتابة نصوص يدوية.
الأمان والشفافية وتقنية SynthID وحدود النماذج
استندت نماذج Gemini 3.8 Audio في تصميمها على مواصفات Gemini 3 Pro، حيث تدعم نافذة سياق ضخمة تستقبل حتى 128 ألف رمز (Tokens) من المدخلات التي تشمل الصوت والصور ومقاطع الفيديو والنصوص، بينما تولد مخرجات نصية وصوتية تصل إلى 64 ألف رمز في الجلسة الواحدة، مع تاريخ معرفي يقف عند حدود يناير 2025.
أكد التقرير الفني للنموذج (Model Card) دمج تقنية SynthID في جميع التدفقات الصوتية المولدة عبر النظام. تمثل هذه التقنية علامة مائية رقمية غير محسوسة للأذن البشرية تندمج مباشرة داخل البنية الصوتية للناتج، وتسمح بالتحقق من أصالة المقاطع الصوتية المصنوعة اصطناعيًا لمنع التضليل وحماية الهوية الرقمية للمستخدمين.
وفي إطار اختبارات السلامة الحدودية المتقدمة (Frontier Safety Framework)، خضعت النماذج لاختبارات أمنية مكثفة أجرتها فرق المحاكاة والتحدي الداخلي (Red Teaming) بالتعاون مع فرق السلامة والمسؤولية في جوجل. أثبتت التقييمات المقارنة مع نتائج نموذج Gemini 3.7 Flash أن نسختي 3.8 Live و3.8 Live Extended Thinking لا تمتلكان أي سلوكيات أو قدرات حرجة غير منضبطة (Critical Capability Levels)، مع مواصلة العمل على رفع الحماية ضد محاولات الاختراق أو كسر القيود البرمجية (Jailbreak).
بهذه الخطوات المتسارعة، ترسم جوجل ديب مايند ملامح جديدة لعالم التفاعل الرقمي، حيث يتحول المساعد الذكي من مستجيب نصي تقليدي إلى شريك صوتي وبصري كامل الأهلية، يفهم السياق الحقيقي، ويفكر بالتوازي، وينجز العمليات المعقدة في اللحظة ذاتها.